目录
阅读范围:本篇只写博客系统本身的搭建与排错。报警部分虽然已经跑起来了,但那是我借助 AI 助手完成的,里面不少逻辑我还没吃透;等我把它研究清楚、自己亲手重搭一遍,再单独写一篇。这个项目我会拆成几篇来写,本篇是其中一篇。
本篇不展开、放到下一篇的:Prometheus / Grafana 监控栈与 node_exporter 采集、alert-check 告警(钉钉 + 邮件)、mysql-backup 备份、tailscale-watchdog 自愈、云监控兜底;以及 Tomcat 的 systemd 托管与 JVM 参数、Nginx 的主备切换与超时压缩。
0. 项目内容
摘要:课程要求买两台服务器做上线实验,我只有一台。这篇记录我怎么用「阿里云 + 本地 WSL + Tailscale」替代第二台服务器,把项目完整上线,并在任务要求之外补上监控、告警、备份和自愈。
开头那张"任务单"是课程交给运维的真实需求(我按工单形式整理),后面是我的方案、实施和踩过的坑。
文中内网 IP、Tailscale IP、密码、Webhook 均已打码;公网访问入口是真实地址。
| 项目 | 内容 |
|---|---|
| 任务编号 | TASK-20261008-001 |
| 任务来源 | Java 开发团队(系统已开发完成,转运维上线) |
| 任务类型 | 项目上线 / 部署实施 |
| 实施角色 | 运维工程师 |
| 环境要求 | 阿里云生产服务器 |
| 优先级 | P3(中) |
| 状态 | 已完成 |
需求说明
目前,公司 Java 开发团队完成了一个博客系统的开发任务,需要运维工程师完成对该项目的上线任务:将该项目部署上线到阿里云生产服务器中,完成最终上线,并对外开放使用。
已准备交付物:ROOT.war、schema.sql、data.sql
第一步:先了解该项目的整体软件架构组成
先搞清楚这个项目由哪些部分组成,才能知道本次运维部署任务中,自己主要承担哪些具体工作。
| 组成部分 | 内容 |
|---|---|
| 开发语言 | Java 1.8 |
| 数据库服务 | MySQL |
| Web 服务器 | Tomcat |
| 反向代理服务器 | Nginx |
由架构反推:运维要承担的具体工作
| 架构组件 | 对应的运维工作 |
|---|---|
| Java 1.8 | 安装并固定 JDK 1.8 运行环境(不能用系统默认的新版本) |
| MySQL | 安装数据库、创建 forum-java 库、导入数据、修改连接配置 |
| Tomcat | 部署 ROOT.war、配置 JVM 参数、做成 systemd 服务(后两项见下一篇) |
| Nginx | 配置反向代理、超时与压缩、后端故障切换(后两项见下一篇) |
关于数据库的说明
| # | 要求 |
|---|---|
| ① | 需要在数据库中准备 forum-java 数据库 |
| ② | 项目提供了基础数据集 schema.sql,要求在部署的时候导入,才可正常使用系统 |
| ③ | 请注意修改项目本身数据库的相关信息,避免无法连接 |
注意:此信息一般会由开发人员提供,或可与开发人员沟通配合上线。
任务拆解
| # | 任务 |
|---|---|
| 1 | 首先,构建生产服务器系统 |
| 2 | 接着,在服务器中依次完成各个软件安装,并进行各阶段项目部署工作 |
| 3 | 最后,在阿里云生产环境完成博客系统上线 |
验收标准:部署上线成功 + 对外开放可访问。
看到这张单子,我的第一个问题是:任务拆解里只提到"生产服务器系统"和"阿里云生产环境",可视频里明确要求两台服务器。
而我手上只有一台。
一、背景:我为什么不买第二台服务器
跟着视频做这个博客项目,第一件事就卡住了:视频里明确要求两台服务器,而我手上只有一台——这台阿里云服务器还是我 5、6 月份就买了的。
再买一台,我最大的顾虑不是钱本身,而是:万一项目没做出来,这笔钱就白花了。 但我又想把视频里涉及的知识点都练到,不能因为少一台机器就不做了。于是我开始找替代方案。
方案一:本地开两台 VMware 虚拟机。 技术上可行,但有几个绕不过去的硬伤:
- 云监控:本地虚拟机接不进云平台的监控体系
- 异地访问:机器放在家里,出了门就访问不到
- 24 小时在线:这一条最致命——本机不是服务器,跑一阵子自己就卡死了
所以我排除了它:这个方案解决不了"7×24 在线"和"异地可访问"这两个最核心的需求。
转折点出现在一个我本来就在用的工具上:Tailscale。 我之前用它组过局域网,想到这里,思路一下子通了:
本地机器真正的短板其实只有一个——不能 7×24 在线。 那如果让本地机器和云服务器互相 ping 通,是不是就等于多了一台"云服务器"?
顺着这个思路,方案就清晰了:
| 角色 | 谁来做 | 解决什么 |
|---|---|---|
| 7×24 在线 | 阿里云服务器 | 业务 + 数据库 |
| 前端接入 | 本地 WSL 主机 | Nginx 反代(PC 开机时在线) |
| 把两者连起来 | Tailscale | 异地互访,不用公网 IP、不用端口映射 |
结论:这个方案不仅合理,还完全能满足视频里的实验需求——甚至比"直接买两台云服务器"多学到了一块组网。
二、项目架构
课程要求两台服务器组成"接入层 + 应用层",两台机器之间通过内网互访。
我要解决的核心问题只有一个:没有第二台云服务器,怎么得到"另一台能互相访问的机器"?
答案是 Tailscale。
2.1 Tailscale 在这里起什么作用
它相当于在 node1 和 node2 之间架了一座桥:
- 把两台机器加入同一个虚拟专用网络(tailnet),行为上跟"同一个局域网"一样
- 每台设备会分到一个
100.64.0.0/10网段内的虚拟 IP(运营商级 NAT 的保留地址段) - 之后两台机器就能用这个虚拟 IP 互相访问——等价于"云服务器 VPC 内网互通"
- ⚠️ 原有 IP 不会变:node2 的公网 IP、内网 IP 都照旧,Tailscale 只是多给了一张虚拟网卡
于是原需求里的"云内网互访",在这里被等价替代:
| 原需求 | 我的实现 | 效果 |
|---|---|---|
| 两台 ECS + VPC 内网互通 | 阿里云(node2)+ 本地 WSL(node1)+ Tailscale 组网 | 等价 ✅ |
| 内网私有 IP | Tailscale 虚拟 IP(100.x) | 等价 ✅ |
| 安全组放行 | 云防火墙 + 主机 firewalld | 等价 ✅(见第三节) |
2.2 两台机器的角色分工
| node1(本地 WSL2) | node2(阿里云) | |
|---|---|---|
| 角色 | 接入层 | 应用层 + 数据层 |
| 装什么 | Java + Nginx | Java + Tomcat + MySQL |
| 干什么 | 反向代理,把请求转发给 node2 | 运行博客应用、读写数据库 |
| 在线时间 | PC 开机时 | 7×24 |
我这边 node1 实际只用到 Nginx(Java 环境是后来做跨机实验才装的);node2 按需求把 Java + Tomcat + MySQL 装齐了。
2.3 架构
请求路径
用户浏览器
├── http://47.101.221.134:8080 ──────► node2 Tomcat A :8080                     主入口(直连云主机)
├── http://100.89.x.x:8080 ──────────► node2 Tomcat A :8080                     内网入口(Tailscale 直连)
└── http://<node1>:80 ───────────────► node1 nginx :80 ──► node2 Tomcat :8080   反代入口(走 Tailscale)
两节点之间:Tailscale 虚拟内网(WireGuard 加密,100.x 网段)
node2 · 阿里云 · CentOS Stream 9 · 2 vCPU / 1.7 G · 7×24
├── MySQL 8.0.46      :3306      业务库 forum-java(13 张表)
├── Tomcat A 9.0.97   :8080      博客应用(systemd 托管)
├── Prometheus 3.15   :9090      采集两台机器指标(保留 15 天)
├── Grafana 10.2.6    :3000      监控看板(手机通过 Tailscale 可看)
├── node_exporter     :9100      主机指标采集
├── alert-check       每分钟      资源告警 → 钉钉 + 邮件
└── mysql-backup      每日 03:30  数据库备份(保留 14 天)
node1 · 本地 WSL2 · AlmaLinux 9 · 16 核 / 11 G · PC 开机时在线
├── nginx             :80        反向代理(主 + 备 + 快速切换)
├── node_exporter     :9100      供 node2 抓取指标
└── tailscale-watchdog           每 5 分钟自愈隧道
上面列出的服务,本篇只搭了 MySQL、Tomcat、Nginx 三个。 Prometheus、Grafana、node_exporter、alert-check、mysql-backup、tailscale-watchdog 这几项的搭建,全部放在下一篇。
2.4 五个关键设计决策
| 决策 | 理由 |
|---|---|
| 用 Tailscale 而不是端口映射 | 两台异地机器免配置组网,不用公网 IP、不用暴露多余端口 |
| 监控栈放 node2 而不是 node1 | node2 是 7×24 的;node1 在 PC 里,PC 一关监控就没了 |
| 指标数据只存一份 + 两个 Grafana 界面 | 避免两套数据打架,从哪个入口看数字都一致 |
| Tomcat 交给 systemd | 手动 startup.sh 的服务,重启机器就没了 |
| 自建告警之外,还要留云监控 | 自建告警住在被监控机器上,机器僵死时它也一起死 |
落地情况:上表五条决策里,只有"用 Tailscale 而不是端口映射"在本篇已经落地;其余四条(Tomcat 交给 systemd、监控栈放 node2、指标只存一份 + 两个 Grafana 界面、自建告警之外留云监控)的具体搭建都在下一篇。
接下来先把博客上线必需的那几个服务装好、配好、放行——这正是下一节的内容。
三、实施过程
3.0 修改主机名
- 先给 node1 和 node2 改主机名
hostnamectl set-hostname node1.itcast.cn
hostnamectl set-hostname node2.itcast.com
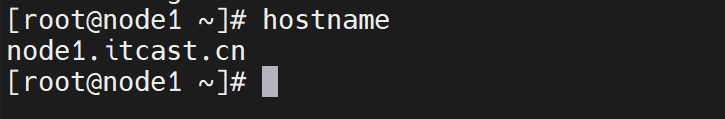
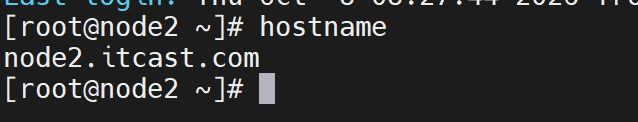
- 接着查看两台机器的 IP,顺便各取一个别名,这需要修改
/etc/hosts
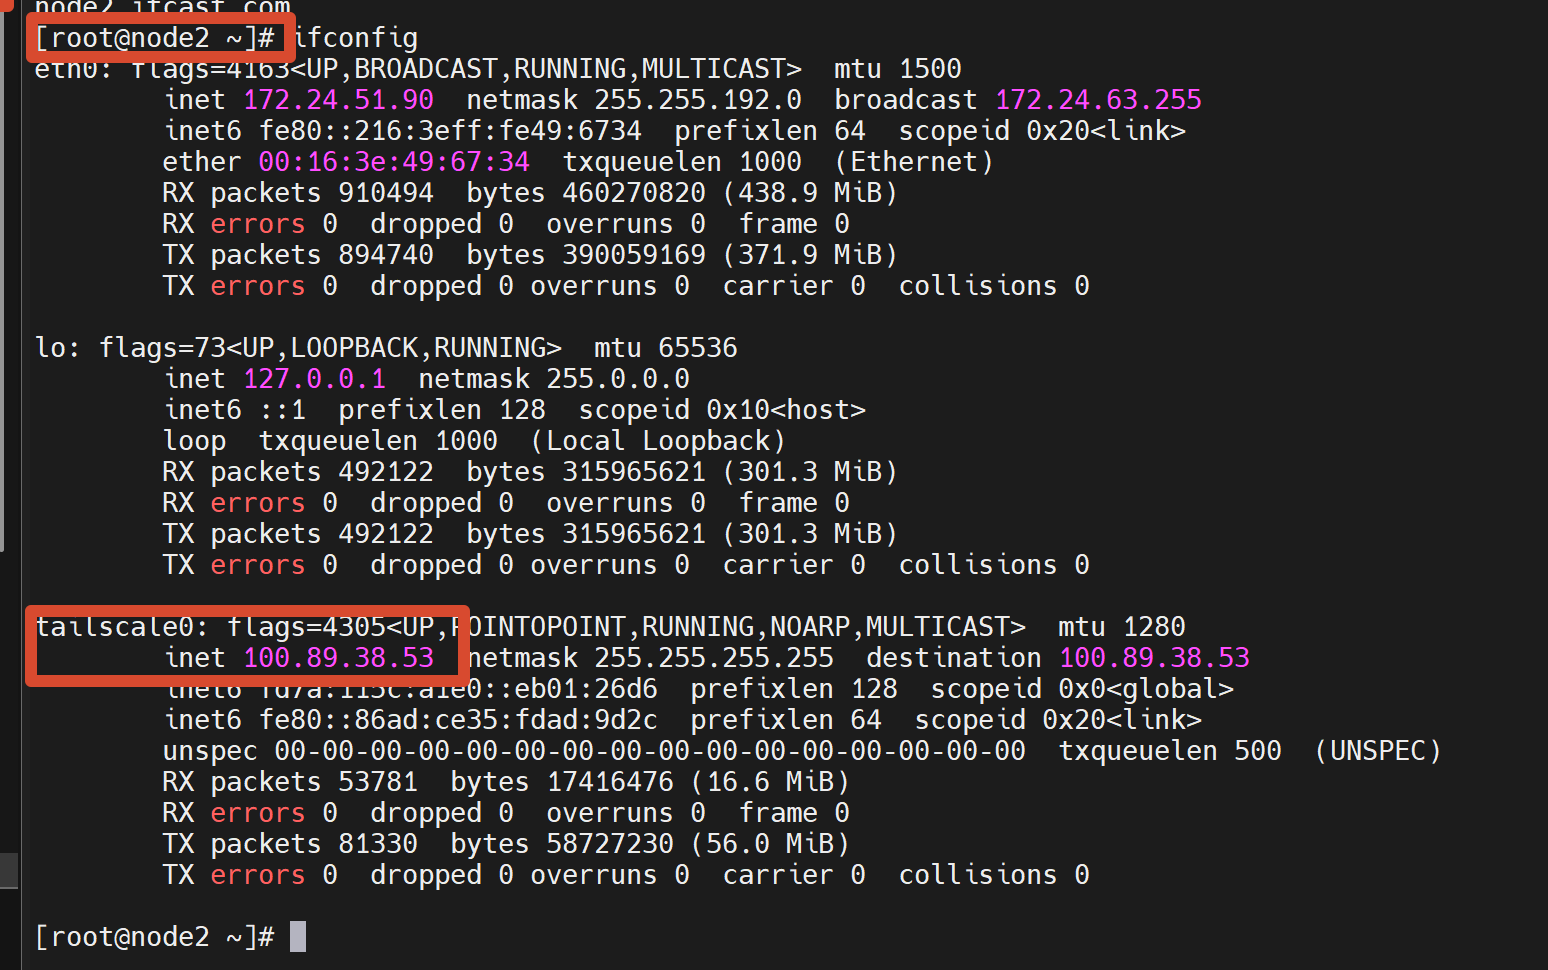
下图是 node2 需要的那个 IP,它其余的 IP 我们用不上。
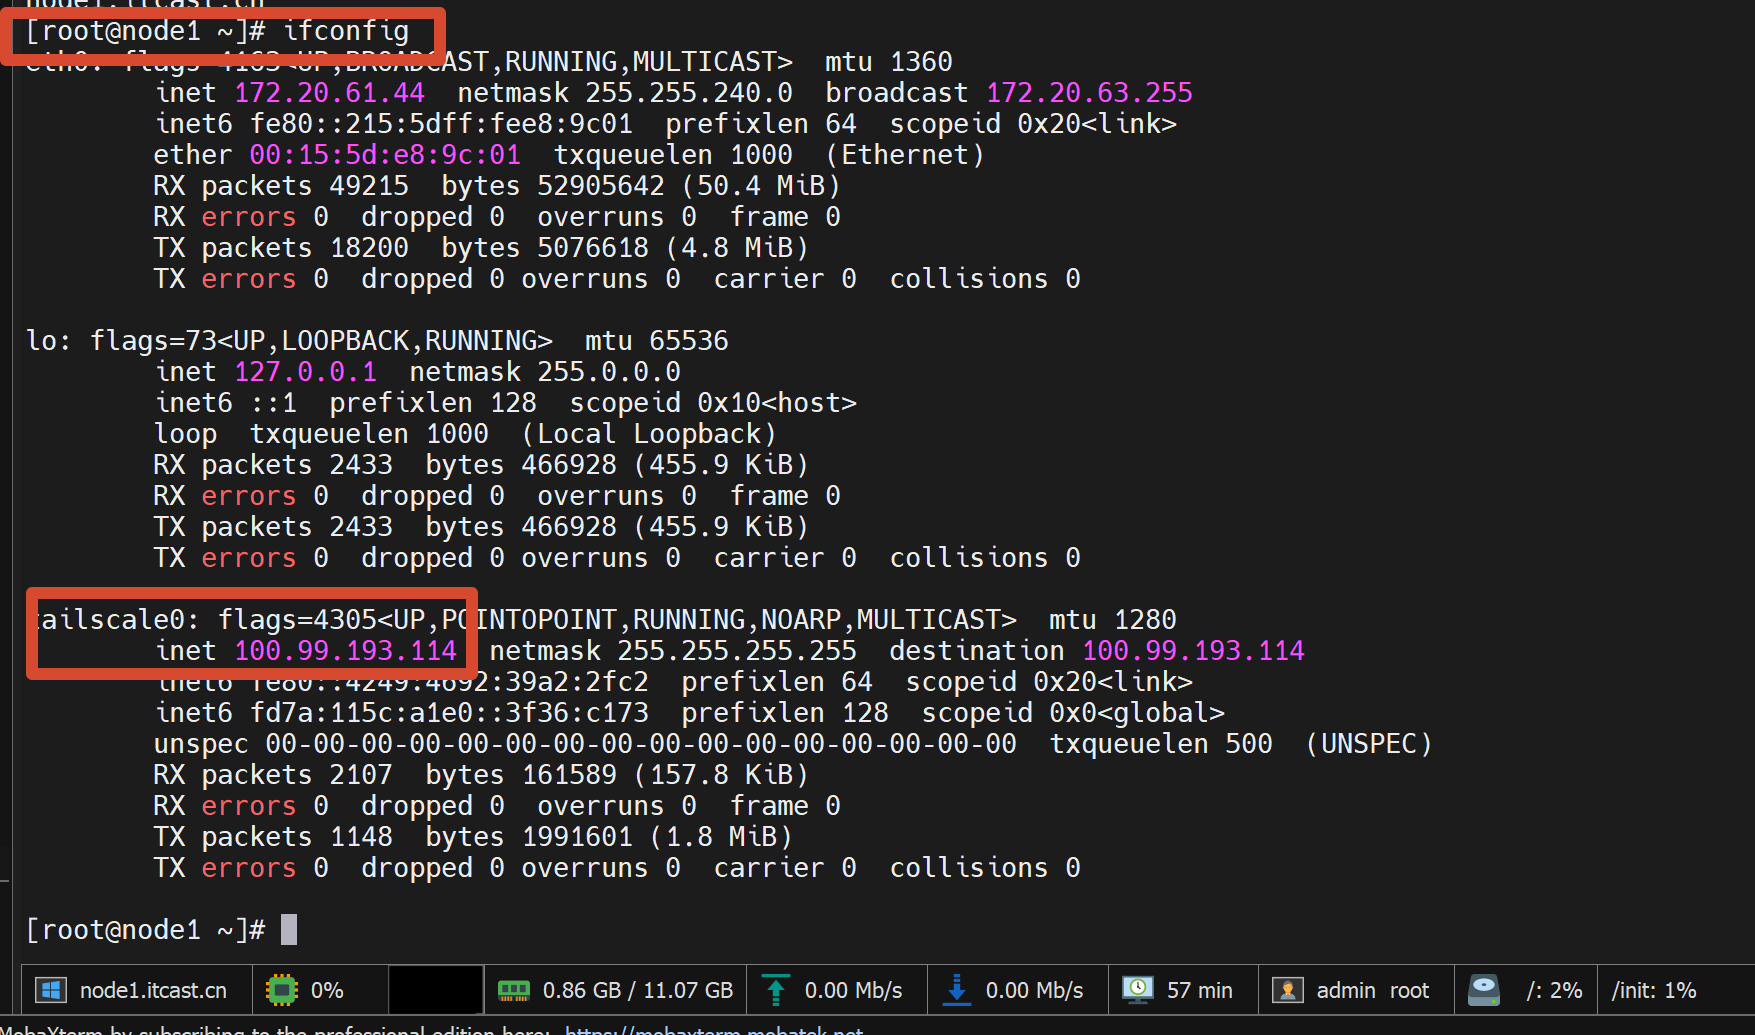
这里则是 node1 需要的 IP。
我们要建立两条映射:node1、node1.itcast.cn 指向 100.99.x.x,node2、node2.itcast.com 指向 100.89.x.x。这样用别名还是主机名都能访问到。
sed -i '$a 100.99.x.x node1 node1.itcast.cn\n100.89.x.x node2 node2.itcast.com' /etc/hosts
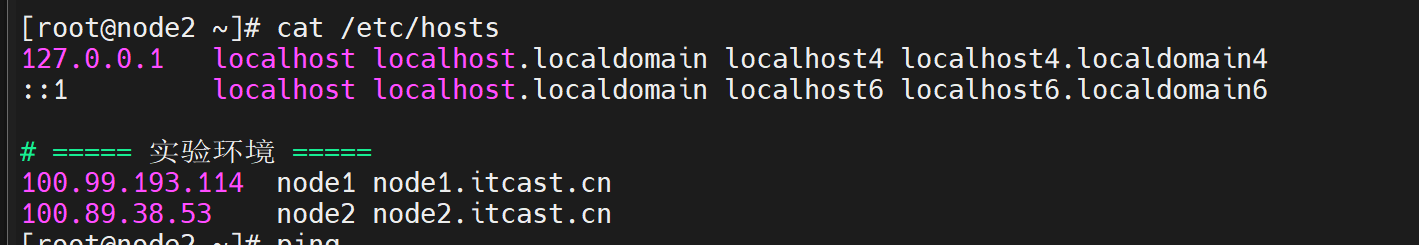
这是 node2 上的配置;node1 同理,把这条 sed 命令复制过去执行即可。
- 最后测一下连通性
ping node1 #node2机器测试
ping node2 #node1机器测试
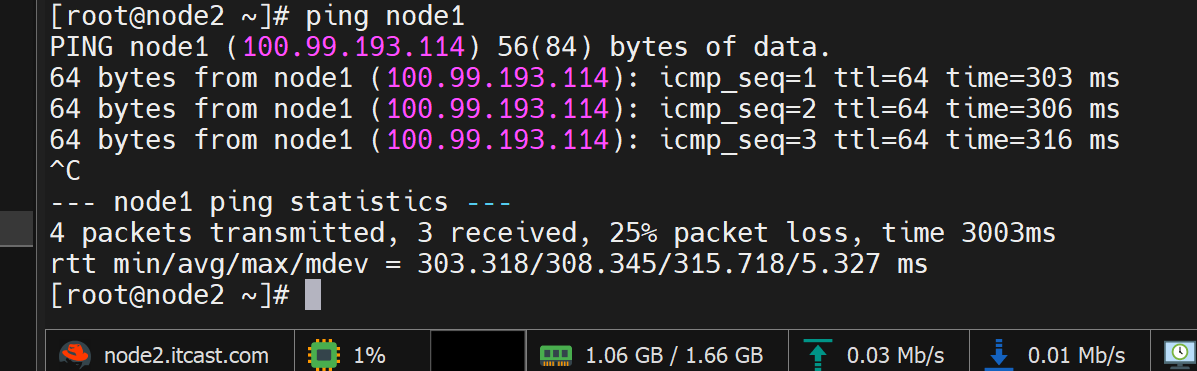
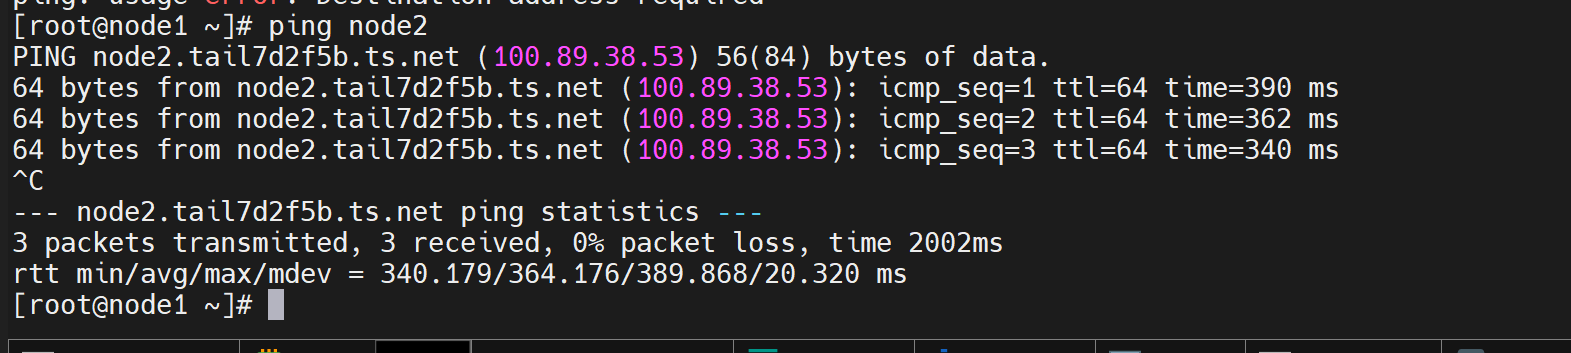
测试结果是:两台主机可以互相访问,用别名也能通。这对后续操作(上传文件、共享目录等)很有帮助。下面开始装软件、改配置、放行端口。
3.1 node1 安装相关软件
- 安装 JDK
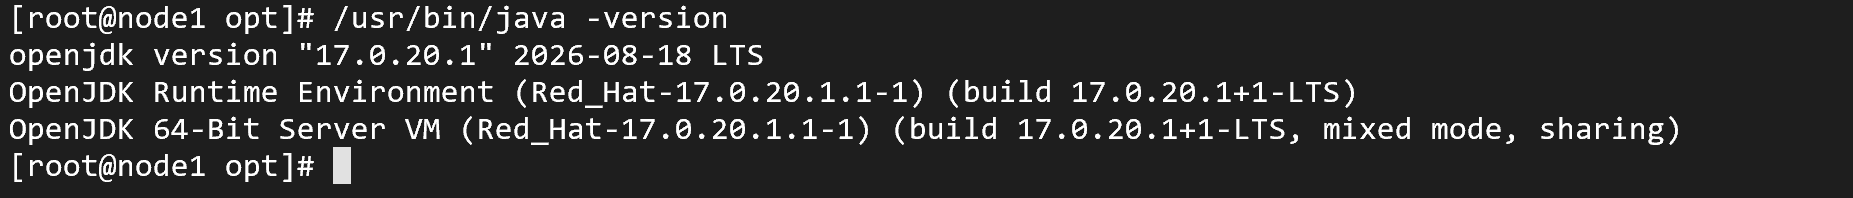
在 node1 上我装的是 java-17-openjdk-17.0.18.0.8-2.el9.x86_64。当时的想法很简单:版本越高功能越全,老版本有的新版本肯定也有。这个选择给后面启动 Tomcat 埋了一个坑,我会在 5.1 节详细说。
dnf install java -y
- 给 JDK 配置环境变量
不配置环境变量的话,在其它目录就调用不到这个软件的 bin 程序——环境变量一般写在 /etc/profile。但这里出现了一个反常现象:我并没有配好环境变量,在其它目录居然也能运行 java。我一度以为是自己之前配过、时间久了忘了,这个问题我在 5.3 节专门做了解释。
服务装好、环境变量配完,这一小节就算完成了。
- 安装 Nginx
先装软件:
dnf install nginx -y
然后改配置文件:
vim /etc/nginx/nginx.conf

# 在 server 块里加入以下内容
location / {
    proxy_pass http://100.89.x.x:8080/;
}

systemctl restart nginx  #重启nginx服务
systemctl enable nginx   #设置下一次开机自启动
systemctl status nginx   #查看nginx的服务状态
firewall-cmd --add-port=80/tcp --permanent  #开放80端口
firewall-cmd --reload          #使防火墙的配置生效
下一篇会补上:Nginx 的主备切换与快速切换(本篇只配了单个后端),以及超时、压缩和后端故障切换。
3.2 node2 上面相关软件的安装
- 安装 JDK
和 node1 上的步骤一样,这里不再重复。
- 安装 MySQL 数据库
dnf install mysql -y
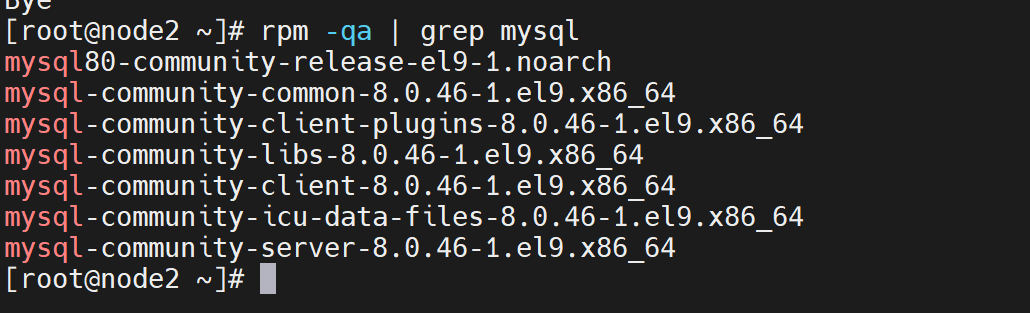
然后修改数据库密码。
- 查看初始密码
grep password /var/log/mysqld.log

- 修改数据库密码
mysql_secure_installation
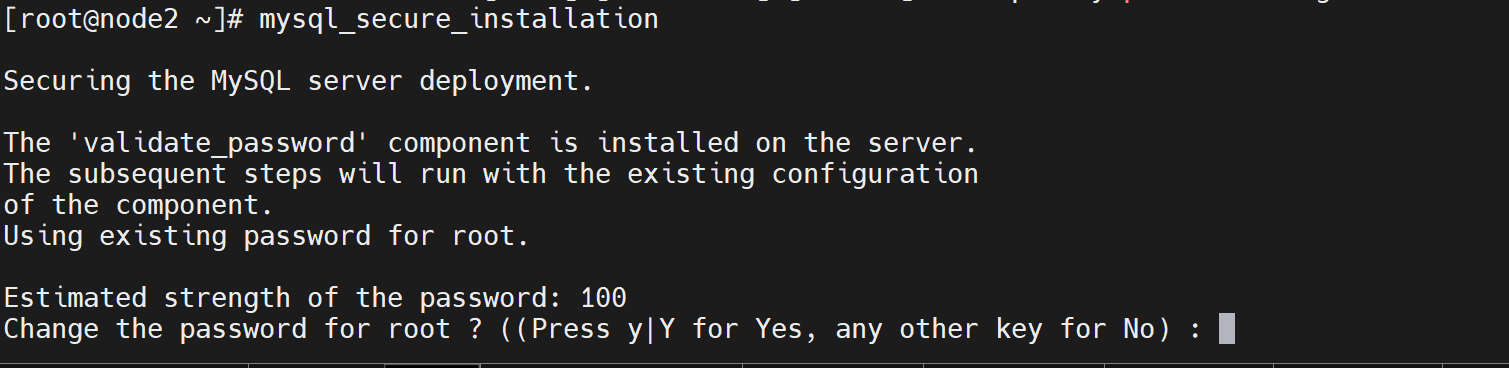
按提示逐项选择即可。
- 测试数据库连接
mysql -uroot -p*** #可以省略密码 直接回车,然后输入密码
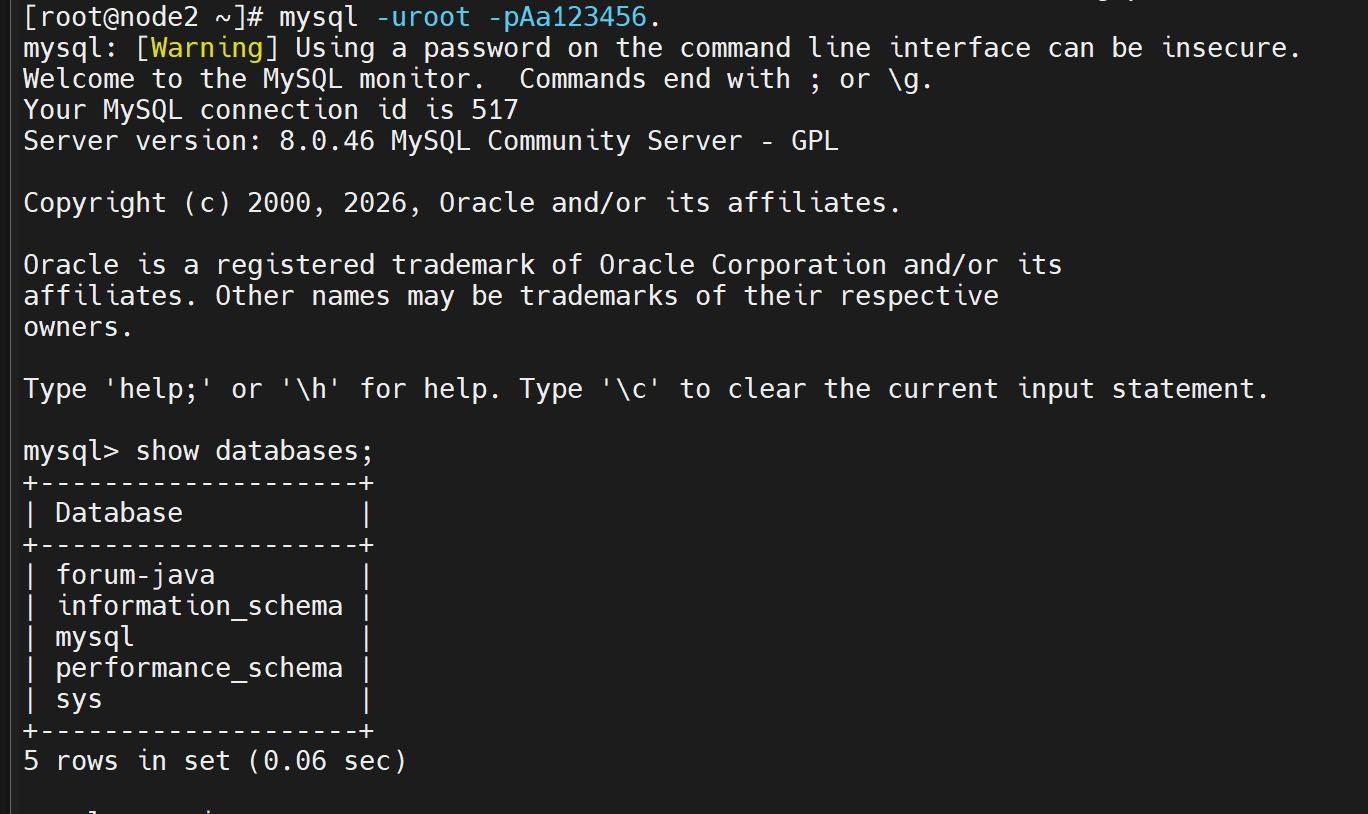
测试通过,密码修改成功。
- 导入数据
我用 mx(MobaXterm)把资源包传到机器上,再导入数据。
cd /export/software
ls
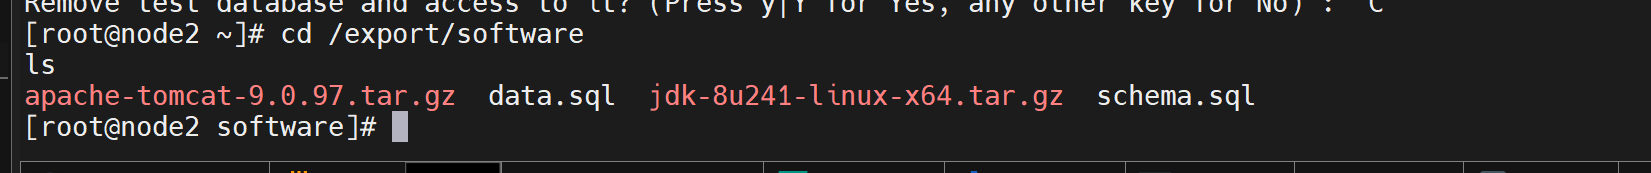
- 导入数据库
mysql -uroot -p***  < schema.sql
mysql -uroot -p***  < data.sql
注意:这里其实也是有一个小问题——导入顺序不能反过来。
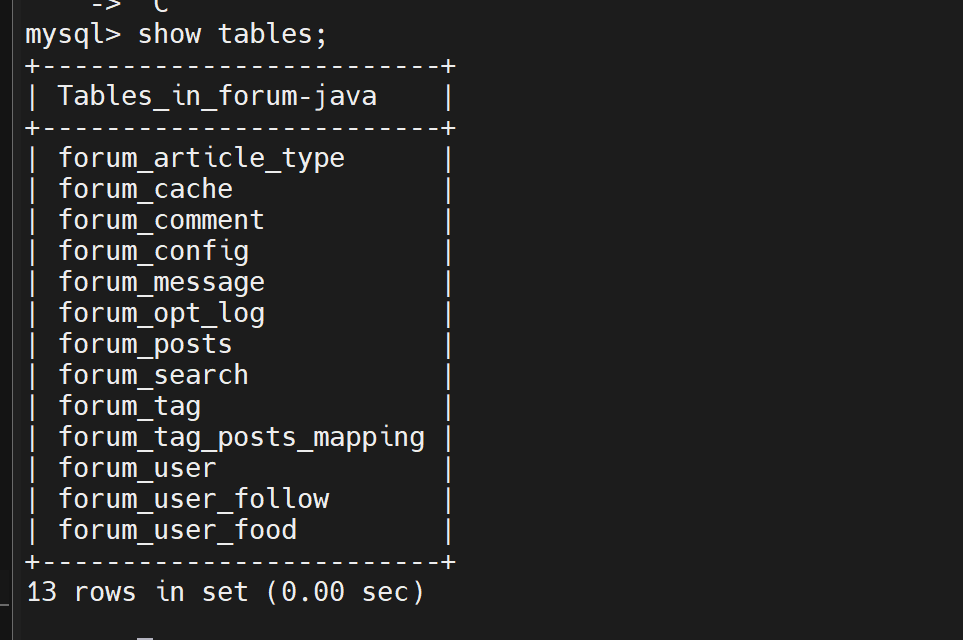
验证通过。
3.3 安装 Tomcat
用 mx 把安装包传到 node2,解压到 /opt 目录:
tar -xzvf /export/software/apache-tomcat-9.0.97.tar.gz -C /opt
- 启动 Tomcat
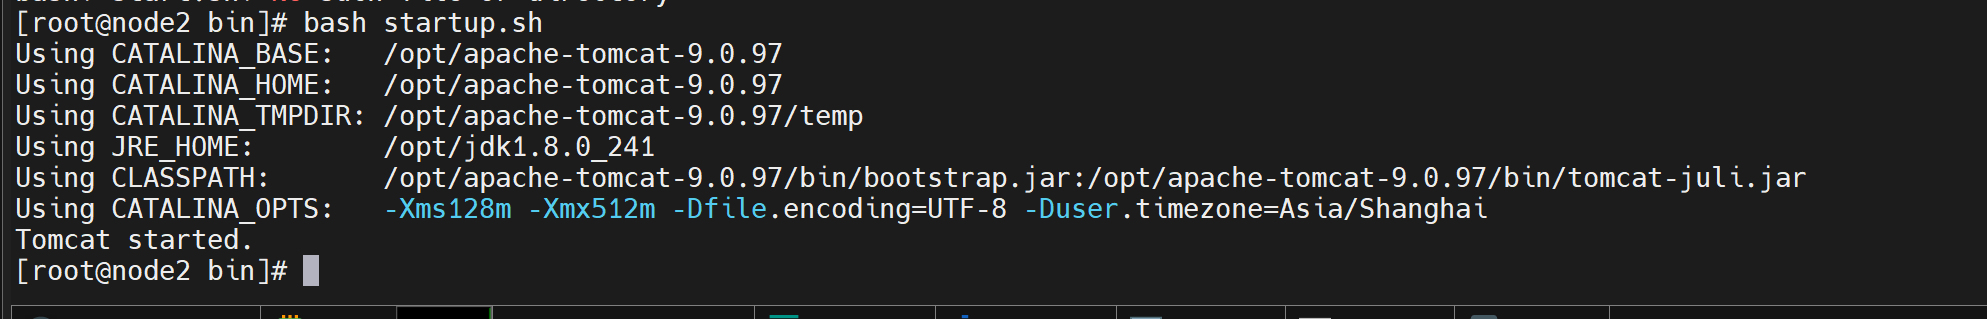
cd /opt/apache-tomcat-9.0.97/bin
bash startup.sh
- 放行端口
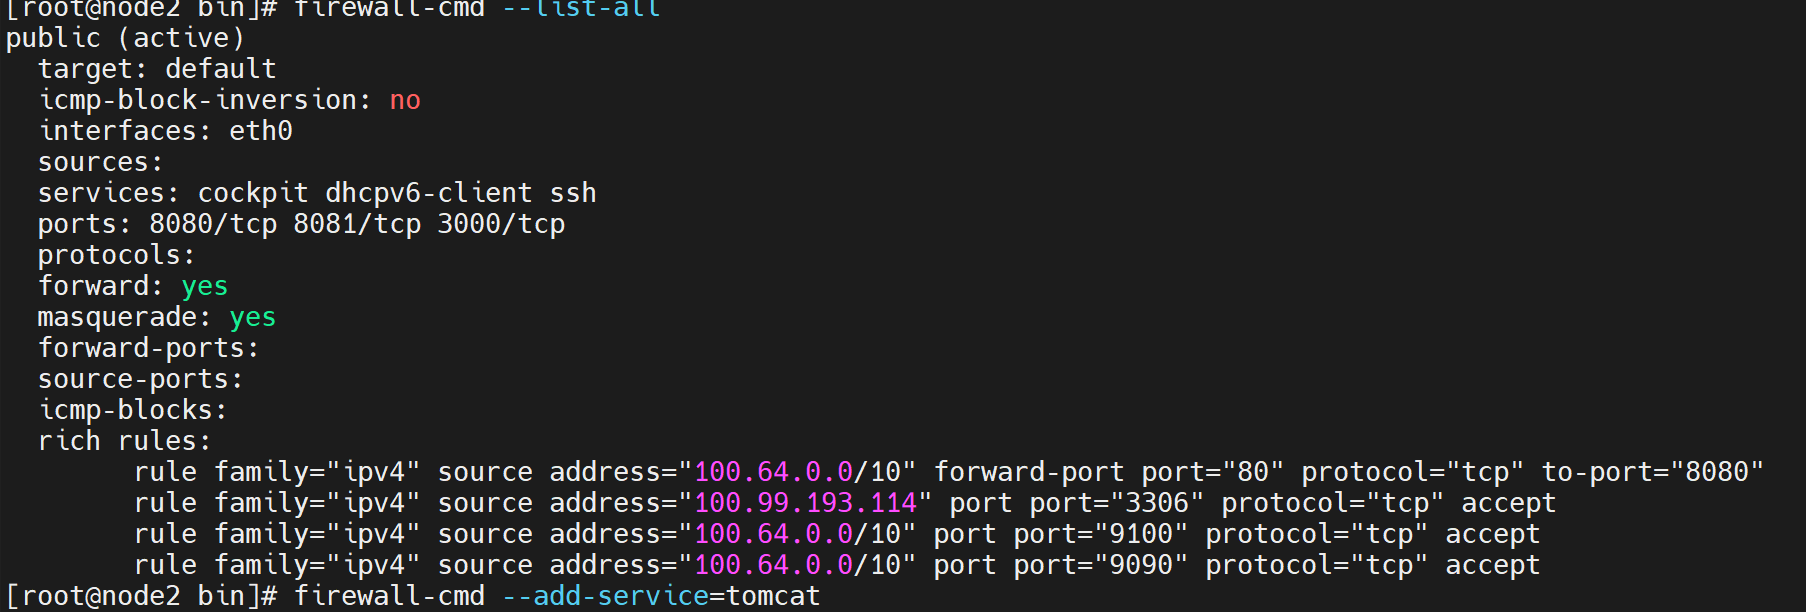
firewall-cmd --add-port=8080/tcp --permanent
firewall-cmd --reload
firewall-cmd --list-all
- 导入 ROOT 应用
先停掉 Tomcat,把 /opt/apache-tomcat-9.0.97/webapps/ 下原有的 ROOT 目录删掉,再放入 ROOT.war。
执行 bash shutdown.sh 停服、再启动,结果服务起不来,报 JDK 不兼容。我折腾了一阵才把它拉起来——原因见 5.1 节。
下一篇会补上:Tomcat 的 systemd 托管(现在还是手动
startup.sh起的,重启机器就没了)和 JVM 参数调整。
四、测试 nginx 反向代理和 node2 的博客访问
两台机器上的软件安装、配置修改和端口放行都已完成,接下来就可以访问这个博客系统了。
- 先在浏览器访问
http://100.89.x.x/,能打开博客首页
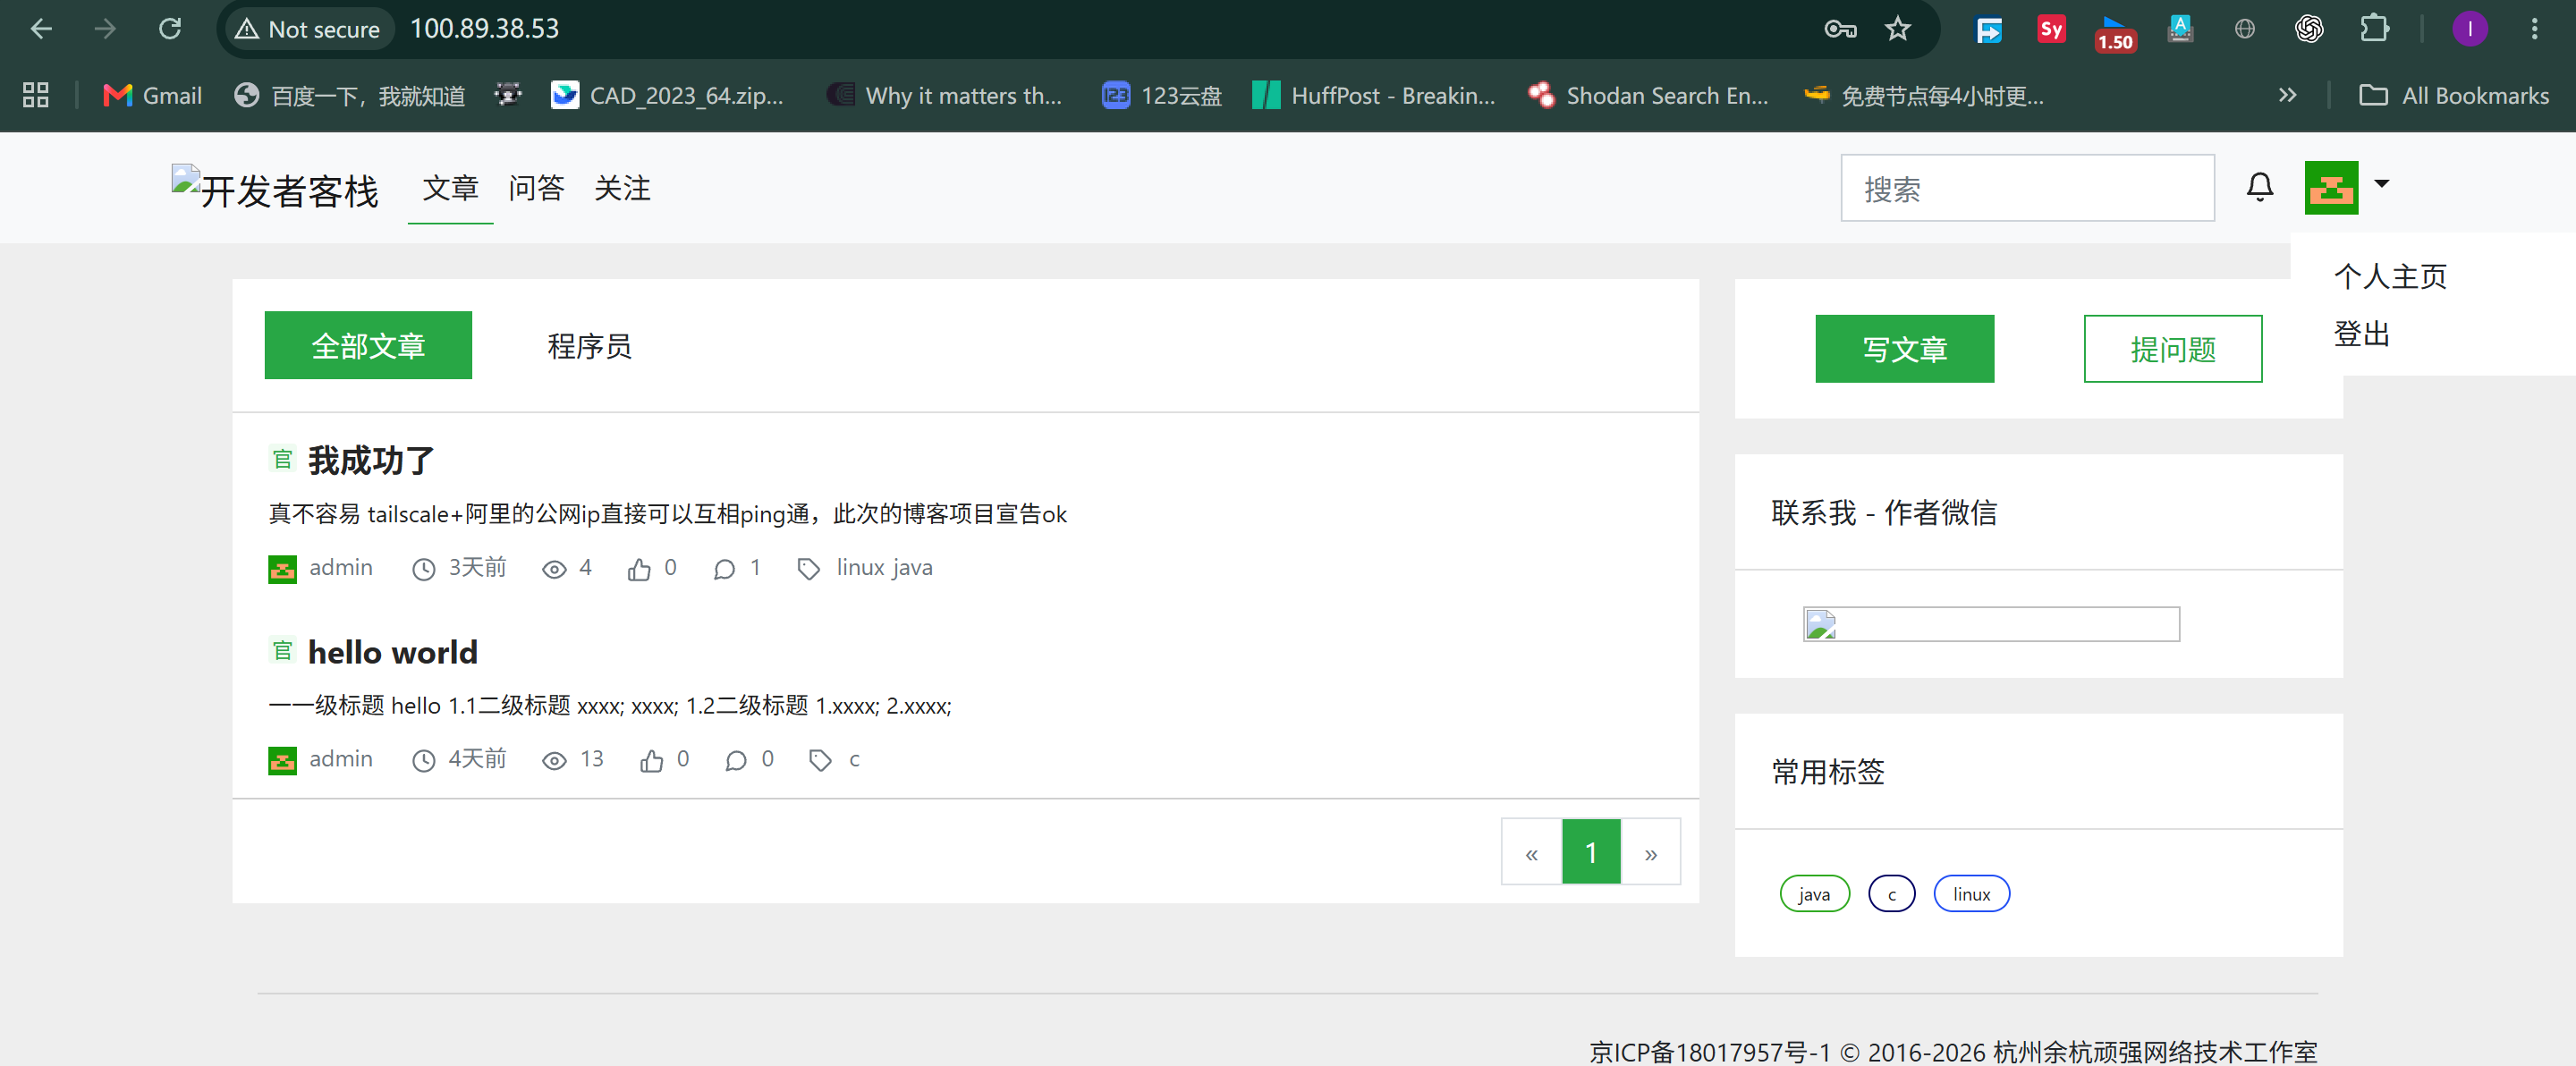
到这一步就成功了:我随手写了几篇博客,都能正常发布,node2 这边没有问题了。接着用 node1 的反代入口再测一次。
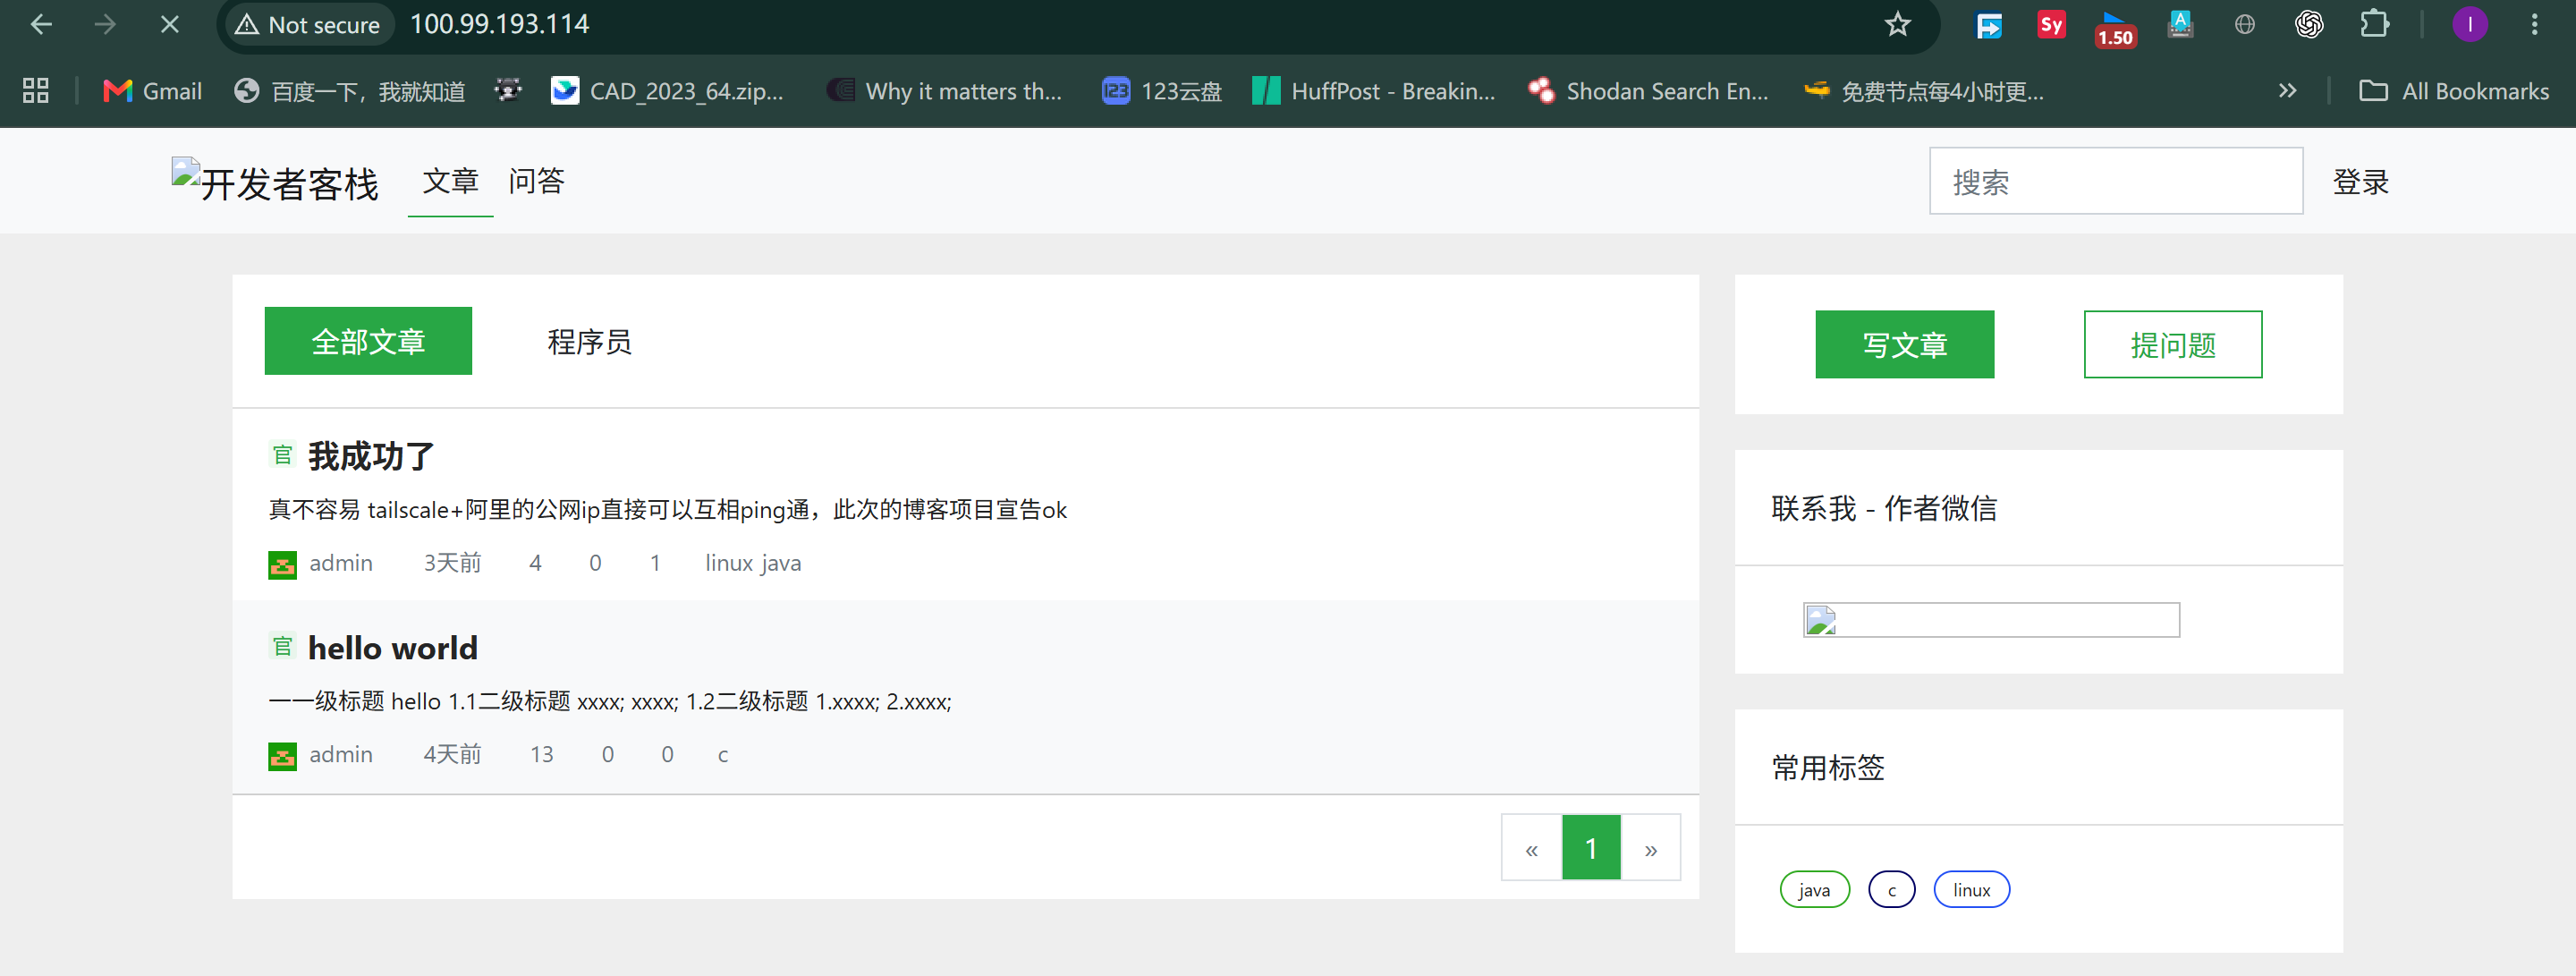
在浏览器访问 http://100.99.x.x/ 也能进入同一个博客,说明反向代理配置也没问题。
验收清单
对着第 0 节的验收标准逐条核对:
| # | 验收项 | 怎么验 | 期望结果 |
|---|---|---|---|
| 1 | 应用本机可用 | 在 node2 执行 curl -I http://127.0.0.1:8080/ | HTTP/1.1 200 |
| 2 | 公网入口可用 | 浏览器开 http://100.89.x.x/ | 博客首页正常显示 |
| 3 | 反代入口可用 | 浏览器开 http://100.99.x.x/ | 同一个博客,页面一致 |
| 4 | 数据库有数据 | mysql -uroot -p*** -e "use \forum-java`; show tables;"` | 13 张表 |
| 5 | 能写能发 | 后台发一篇测试文章 | 保存成功、前台可见 |
| 6 | 端口已放行 | firewall-cmd --list-ports | 含 8080/tcp、80/tcp |
验收结论:第 0 节的验收标准(部署上线成功 + 对外开放可访问)全部满足。
到这里,博客系统本身已经跑通了。下面记录我踩过的坑和解决过程。
五、遇到的问题以及解决思路
5.1 JDK 安装包版本号不兼容
我当初在网上随手下了个 JDK 安装包,挑了最新版本——想着新版本总该兼容老版本,就没多想。结果导入 ROOT.war 之后再启动 Tomcat,服务死活起不来。
明明是按实验要求做的,服务就是不动,当时挺着急。后来我一遍遍翻实验要求,终于发现有一处和我做的不一样:要求明确锁定 JDK 1.8,而我装的是高版本。
我此前没往这个方向想;抱着死马当活马医的心态按 1.8 处理,服务居然起来了。为了搞懂原理,我把这个疑惑拿去问了 DSH,得到了明确的解释:
不是 Tomcat 老旧,是 ROOT.war 里的老旧依赖(2017-2018 年的 mail / activation)引用了 JDK 16 已删除的私有类,而系统默认 JDK 是 17 —— 属于"老应用 + 新 JDK"的不兼容。
两条修法:① 把运行 JDK 降到 8(我用这条,最稳,不动应用);② 让开发升级这些老依赖(治根,但要改代码)。
Tomcat 9.0.97(2024,新)  +  应用里的老依赖(2017-2018 年的 mail/activation)
                              ↓
                引用了 JDK 内部类 com.sun.net.ssl.internal.ssl.Provider
                              ↓
该类在 JDK 16 被移除 → Java 17 下加载失败
也就是说,问题出在 ROOT 应用本身的老旧依赖上,和 Tomcat 版本无关。这个问题就此解决。
5.2 数据库的导入顺序
素材给了两个 SQL 文件。我当时想当然:反正都是数据库脚本,随便导哪个都行。结果一导入就报错了。
[root@node2 software]# mysql -uroot -p*** <data.sql
mysql: [Warning] Using a password on the command line interface can be insecure.
ERROR 1049 (42000) at line 1: Unknown database 'forum-java'
这一步没留截图,只能把报错原文贴出来。报错直说了"未知的数据库"——也就是库根本还没建,我就直接往里导数据了。回头再看两个文件才发现,建库建表那部分在 schema.sql 里。
schema.sql开头的第 4、5 行就是:DROP DATABASE IF EXISTS `forum-java`; CREATE DATABASE `forum-java`;
顺带把几个容易混淆的邻近报错整理在这,方便对照:
| 报错 | 含义 |
|---|---|
ERROR 1049 (42000): Unknown database 'forum-java' | 库都没建(schema 没跑)← 你这次就是这个 |
ERROR 1146 (42S02): Table 'forum-java.xxx' doesn't exist | 库建了但表没建(schema 没跑完/被删) |
ERROR 1045 (28000): Access denied for user 'root'@'localhost' | 密码错(密码结尾的句点丢了),与顺序无关 |
搞清原因后,把导入顺序调过来(先 schema 后 data),建库建表就都正常了。截图在上面已经贴过,这里不再重复。
5.3 JDK 环境变量问题
做实验之前,我应该已经在 node2 上装过 JDK。可这次一查才发现:环境变量并没有指向它。奇怪的地方在于——教程明确说"不配环境变量,在其它目录就调用不到 java",而我这里不配也能在任意目录运行。
另外我注意到,dnf 装出来的 JDK 目录摊得很散,不如直接解压 tar.gz 来得整齐:解压完所有东西都在同一个根目录下,查看起来方便。
/usr/bin/java            ← 入口(软链,不占地方)
/etc/alternatives/java   ← 中转软链
/usr/lib/jvm/java-17-openjdk-17.0.20.1.1-1.2.el9.alma.1.x86_64/
    ├── bin/ lib/        ← 运行时真身
    └── conf  ──软链──▶  /etc/java/java-17-openjdk/.../conf   ← 配置在 /etc!
/var/lib/alternatives/   ← 版本切换的"数据库"
/usr/share/java          ← 由 javapackages-filesystem 提供的空骨架目录
tar.gz 就相当于"一个压缩包 = 一棵完整的目录树",解压后所有内容都在同一个根目录下:
/opt/jdk1.8.0_241/          ← 一个根目录,1586 个文件,390M
├── bin/        ← 40 个工具全在这:java javac jar keytool javadoc javap jcmd jstack jmap jps …
├── lib/        ← 运行库
├── jre/        ← 内含 JRE,配置在 jre/lib/security/{java.security, cacerts, policy}
├── include/    ← 本地方法头文件(编译 JNI 用)
├── man/  src.zip  javafx-src.zip  release  LICENSE …
后来我查了资料才明白:dnf 会把 JDK 拆开存放,不是 JDK 想拆,而是 Linux 发行版的"公共规则"要求它必须拆——FHS 布局规范、RPM 包管理机制、alternatives 多版本机制、拆包子包策略,四条叠加的结果:
| 文件种类 | 必须放哪 | 为什么 |
|---|---|---|
| 可执行入口 | /usr/bin | PATH 才能找到 |
| 库/运行数据 | /usr/lib/jvm/... | 架构相关、随系统共享 |
| 配置 | /etc/java/... | 必须独立备份;dnf upgrade 时不能覆盖你改过的配置 |
| man 手册 | /usr/share/man | man java 要能查到 |
| 版本切换元数据 | /var/lib/alternatives | 可变运行时状态,属于 /var |
原因就很清楚了:可执行入口被放在 /usr/bin,而它在 PATH 里,系统自然能找到,所以不需要额外配环境变量。下面是我查资料后的总结:
RPM 是按"操作系统"的规则装软件,不是按"软件自己"的规则装。 FHS 要求可执行、库、配置、文档分目录;包管理要求有文件清单和固定入口;alternatives 要求入口与实现解耦以支持多版本切换;再加拆包省空间。
所以 dnf 装的 JDK 会被摊到 /usr/bin、/usr/lib/jvm、/etc/java、/var/lib/alternatives,靠软链串成一个整体。
tar.gz 是"绿色版",自包含但不受系统管理,两者取舍不同。
- 弄清原因之后,改起来就快了:重装 JDK 8、写入环境变量,然后在终端里输入:
javac
java
能正常输出结果,就说明配好了。
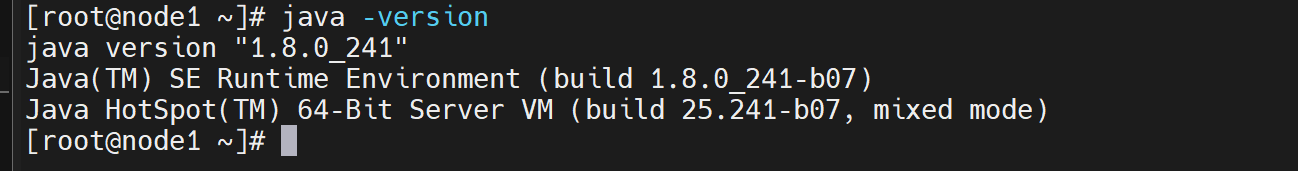
这是 node1 上的结果,配置没问题。
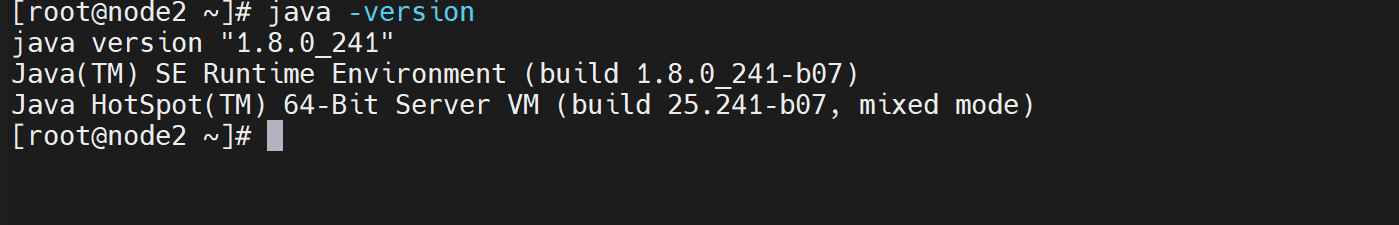
这是 node2 上的结果,同样正常。这个小问题到此解决。
5.4 WSL 里 ssh node2 被"掐断",IP 却是 198.18.0.22
后面有一次我连 node2,突然就连不上了,一直没反应。当时代理开着,并且启用了 TUN 模式。
$ ssh root@node2
Connection closed by 198.18.0.22 port 22
怪就怪在:node2 明明是 100 网段,怎么会连不通?我试着把代理关掉,立刻就通了,解析出来的也是 100 网段。
原因是 Windows 上的代理(Clash Verge)开了 TUN + fake-ip DNS,而 WSL 的 DNS 走的是 Windows 的解析链,于是被塞进了一个假 IP。把 TUN 关掉,访问就恢复正常了。
5.5 Tailscale 的 DNS 问题
第二天重启电脑后,我发现 node1 上的 hosts 记录丢了——在 WSL 里这算常见,重写一份就行。但我顺手 ping 了一下 node2,居然通了,地址还是 100 网段;反过来从 node2 ping node1 也没问题。这一点就很奇怪了:我并没有写过 hosts。
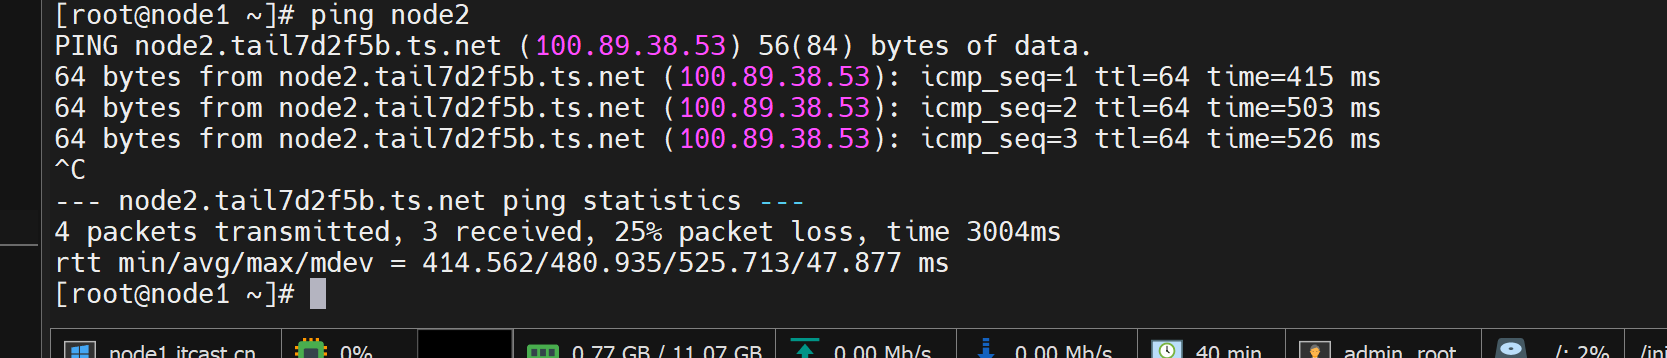
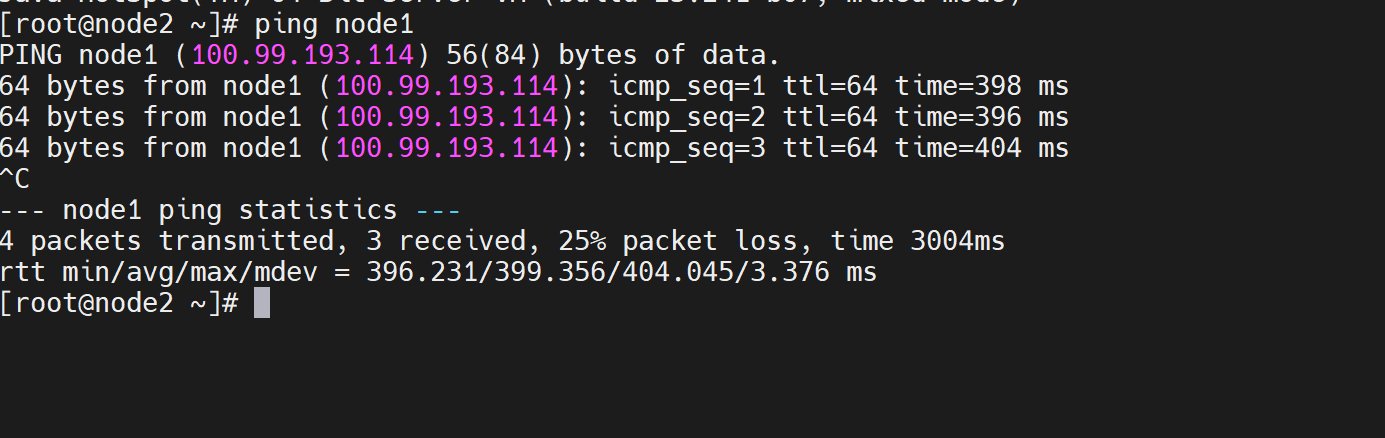
更奇怪的是,用 node1 ping 我的手机也通——可我同样没在 hosts 里写过手机。
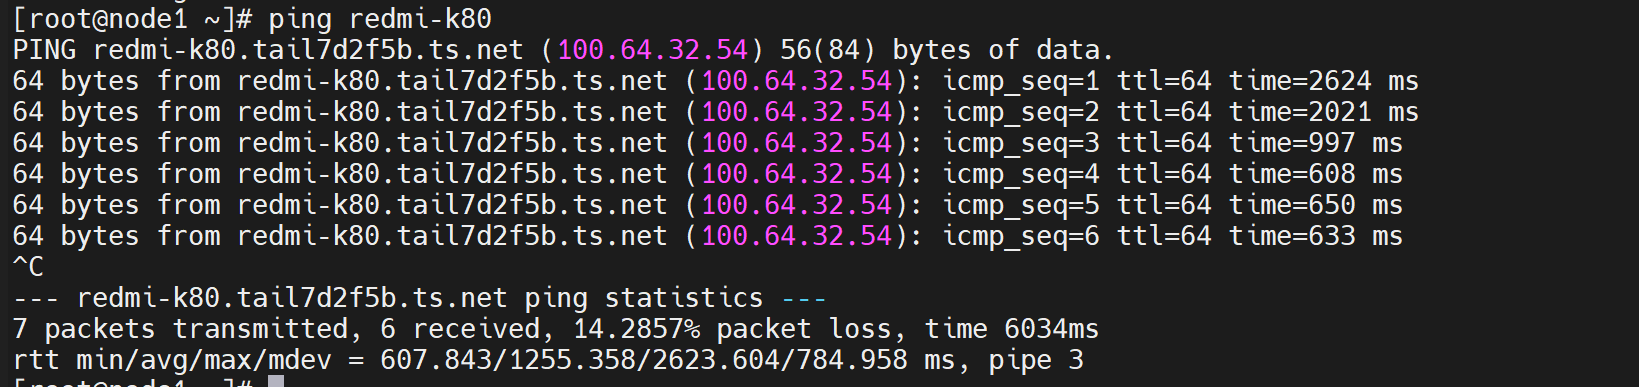
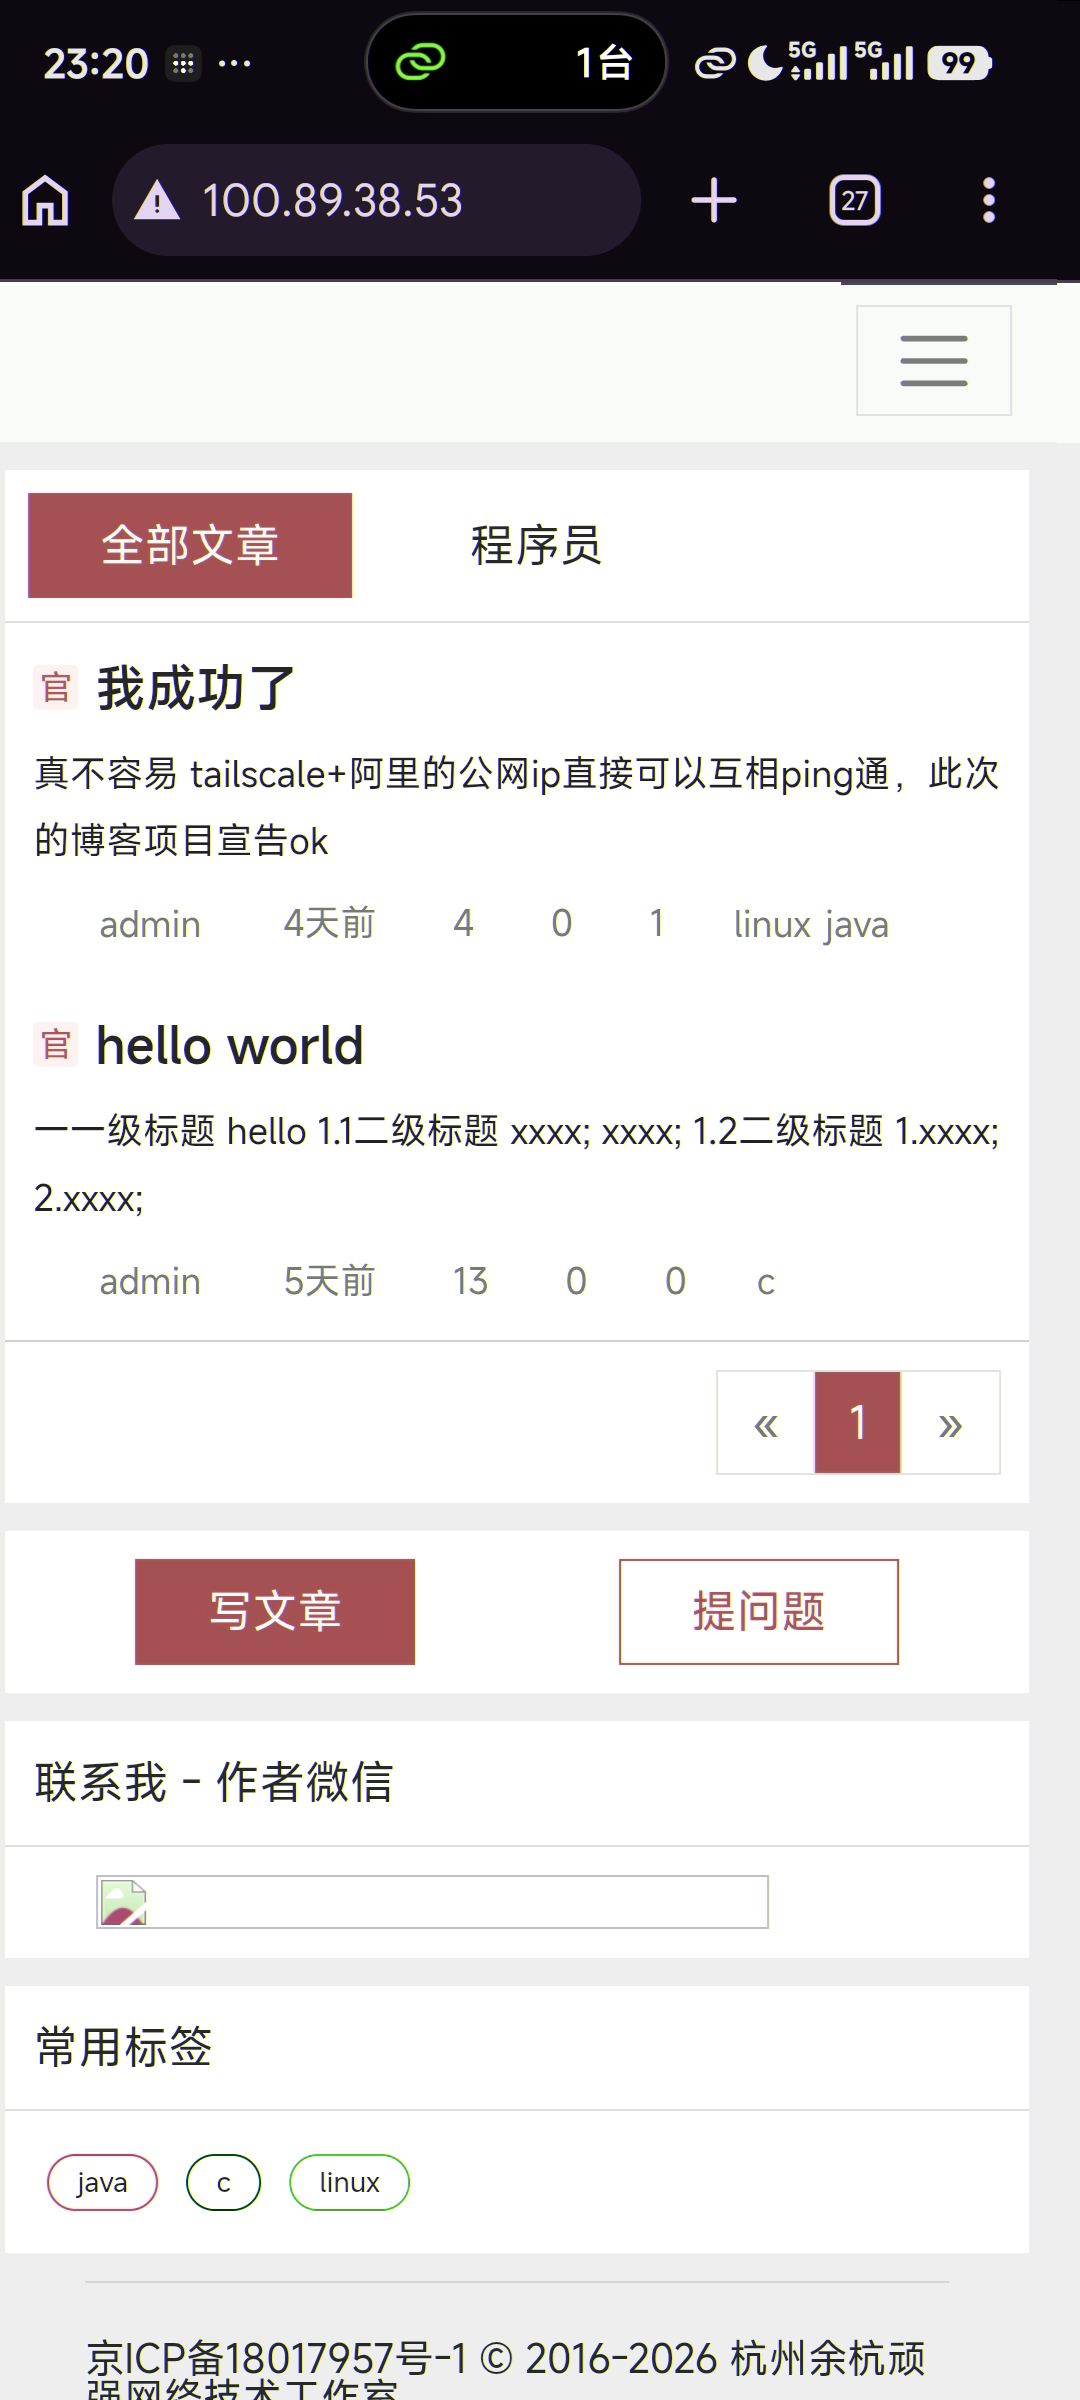
后来才明白:这里走的是 Tailscale 自己的 DNS。在同一个 tailnet 内,被授权的设备可以直接用设备名互相访问,不需要在 hosts 里手工登记。这个设计省事不少,也是我觉得 Tailscale 最强的地方。
这样一来,博客系统既可以从 node2 走,也可以从 node1 走,效果和两台服务器直连是一样的;而且只在 tailnet 内可达,授权设备(包括我的手机)都能异地访问——安全性比直接暴露公网高得多。
总结与思考
回头看,我的原始需求其实很简单:一是把 B 站上这个项目涉及的知识点都练一遍,二是不想为它再买一台服务器——我本来就已经有一台阿里云,万一项目没做出来,这笔钱就白花了。顺着这个约束,才想到用 Tailscale 组网的方案,也找 DSH 确认过可行性:难度不高,只是步骤繁琐。
先拿改进后的环境练手,等以后真买了第二台服务器再做一遍,经验可以直接照搬,几乎不会失败。
需要说明的是,这个实验还带一套邮件 + 钉钉的报警系统,那部分是 DSH 帮我实现的,里面的逻辑我自己还没吃透,所以本篇没有写。这篇只覆盖博客系统的搭建、我遇到的问题,以及自己的思考。
关于"没按题目来":题目要求两台服务器,我确实绕了一下。但需求真正约束的是"接入层 / 应用层分离 + 两层之间走内网互访"——我用「阿里云 ECS + 本地 WSL + Tailscale」把这两条都满足了,只是用 WireGuard 虚拟内网等价替代了 VPC。
所以这不是偷工减料,而是在预算约束下对需求做了一次等价替换。真正要说的不足是:node1 跟着我的电脑开关机走,做不到 7×24(这一点我在架构上已经用"监控栈放 node2"主动规避了),以及报警链路我还没完全掌握——这是下一步要补的。
最后一点:我的实施步骤和视频里几乎一样,唯一的差别就是网络架构。实验过程中遇到的问题和我的思考,未必对每个人都有用,但我还是想写出来——比起"照着做一遍",我更想记录的是怎么把任务要求和自己的实际情况对起来想:先看清需求真正在意什么,再看手上有哪些资源,最后才谈方案。
Tailscale 在这方面帮了大忙,公网、私网、局域网的组合它都能搭,进去之后操作极其顺手,安全性也够。
评论
留言
无需注册,留个名字即可。理性发言,彼此尊重。
正在载入留言…