目录
摘要:这篇文章记录我复习 Linux grep 时踩过的一串坑:引号加不加到底有没有区别、反斜杠什么时候生效什么时候被吃掉、/example/ 为什么在 grep 里不好使、命令敲下去为什么"没反应",以及 BRE / ERE / PCRE 三套方言的区别。全文按「现象 → 原因 → 结论」组织,一共 7 个疑惑,末尾附一张速查表。
核心结论(TL;DR):你敲的每个字符要先过 Shell 这一关,再过正则引擎那一关——引号决定反斜杠能不能活着到达 grep;-E 只是换方言,-P 才是换引擎;grep 没有 /.../ 定界符;写正则一律用单引号。拿不准的时候别猜,echo "最小样本" | grep -oE "你的正则" 一眼就能看穿它到底理解成了什么。
前言: 这篇不打算从 grep 的命令介绍写起——那些看 man 手册更快,写个操作指南意义不大。我只把自己当时真正懵住的地方记下来:为什么加不加引号结果一样、为什么
/example/不管用、为什么命令敲下去"没反应"、为什么两条不同的命令输出一模一样。 每个问题都按「现象 → 原因 → 结论」写,末尾附一张速查表。文中的命令我都在自己的 Linux 机器上跑过,输出照抄。
1. 问题背景
我是在学 Linux 三剑客的时候学到 grep 的。当时觉得这命令简单得很——不就是查字符串吗,能有什么坑,于是没怎么上心。 等三剑客和正则都学完,回头复习 grep 的时候,我整个人是懵的:明明学过的知识,凑在一起用就全乱了。awk 里能用的写法 grep 不认,正则里的量词一会儿是一会儿又不是,命令敲下去还经常"没反应"。 下面这些问题,我一个个查、一个个试,花了不少时间才理顺。说实话这套规则确实繁琐,但理顺之后回头看,其实就是一句话的事——这句话我放在第 2 节,建议先看它。
1.1 先准备一份测试数据
新建一个 demo.txt:
vim demo.txt
Hello, this is an example file.
 It contains some lines of text.
Let's use grep to search for specific patterns.
后来测试的时候,我又往里面补了几行(后面有几条命令会用到):
example. example example
example    exampleexampleexample
*.txt 11312
1.2 第一条命令
按照练习文档的要求,筛选包含 example 的行:
grep "example" demo.txt
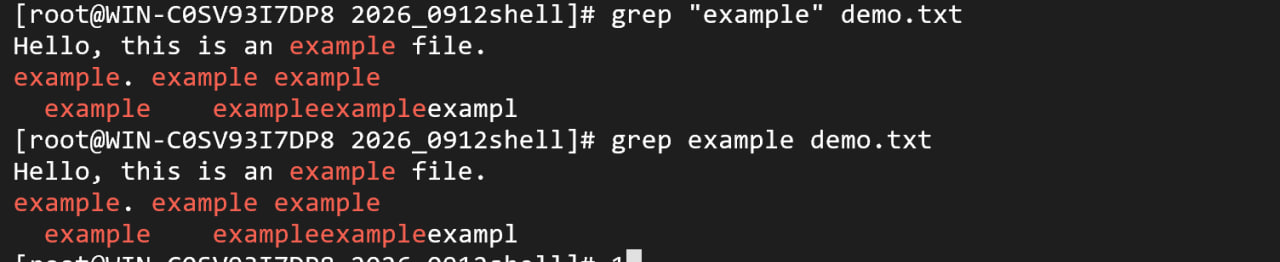
命令本身没有任何问题,问题出在我后来的"多想"上——我试着把引号去掉,发现结果一模一样:
grep example demo.txt # 输出和上面完全相同
既然结果一样,那引号是干嘛的?为什么答案偏偏要加引号?这是我第一个疑惑。
2. 先记住一件事:你敲的字符,要过两道关卡
这是整篇文章的主线,后面的所有疑惑基本都能挂到它上面:
你在终端敲下的一行命令,先由 Shell 处理一遍,剩下的才交给 grep 或 awk;而 grep 拿到的东西,往往已经不是你敲的那个样子了。
- 第一关:Shell。它负责分词(把一行切分成一个个参数)、处理引号、展开变量、展开通配符、处理反斜杠。
- 第二关:grep / 正则引擎。它拿到参数之后,再按 BRE / ERE / PCRE 的规则去解释那个"模式"。
同一个 \example\+,过完两关会有两种命运:
| 环境 | 第一关(Shell) | 第二关(正则引擎)看到 | 结果 |
|---|---|---|---|
| 终端 | 把反斜杠吃掉:\e→e、\+→+ | example+,+ 是量词 | 匹配到 example |
| 网页正则测试工具 | 没有这一关 | \example\+,\+ 是字面加号 | 去找 example+,匹配不到 |
同一串字符、两个结果,差别只在"过没过第一关"。 还有一个更常见的后果:第一关还会悄悄改变参数的个数——一个空格、一个反斜杠,就可能把本该是"文件名"的东西卷进模式里,让 grep 完全跑偏。第 4 节那个"命令没反应"的坑,就是这么来的。
3. 疑惑一:引号加不加、加哪种,到底有没有区别
3.1 简单字符串:结果一样,但原因值得知道
在最简单的场景下(模式只是纯字母、没有空格、没有特殊符号),grep "example" demo.txt 和 grep example demo.txt 的结果完全一样。
原因是 Shell 的"剥壳"机制:你敲 grep "example" demo.txt 时,Shell 先接手解析,看到双引号就把引号剥掉,最终传给 grep 的参数就是纯粹的 example。既然 grep 收到的参数一样,结果自然一样。
理解这一点就能记住结论:引号不是给 grep 看的,是给 Shell 看的。grep 从来没有见过你打的那些引号。
(顺便说一句:如果你在正则里真的写了引号,比如 grep '"example"' demo.txt,那 grep 就会老老实实去找带双引号的字符串——引号对它来说也只是普通字符。)
那引号什么时候才有区别?只要模式里出现下面三类东西,加不加、加哪种,结果就天差地别。
3.2 包含空格:Shell 会把一个参数切成两个
不加引号:
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep hello world demo.txt
grep: world: No such file or directory
demo.txt:grep hello world demo.txt
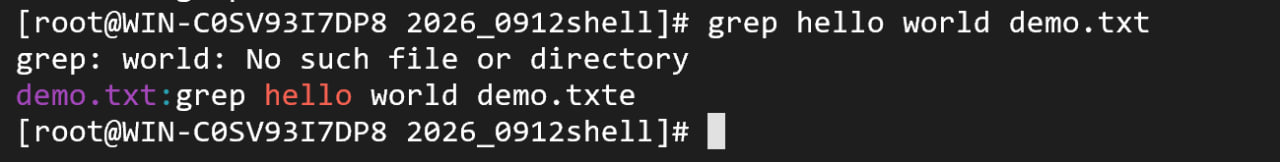
Shell 把空格当分隔符,grep hello world demo.txt 被切成了三个参数:模式是 hello,要搜的文件是 world 和 demo.txt。
所以 grep 报错说 world 这个文件不存在,然后老老实实在 demo.txt 里搜 hello——搜到的正是我写进去的那行命令文本。
加上引号:
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep "hello world" demo.txt
grep hello world demo.txt

双引号让 hello world 保持为一个参数,grep 会把"hello world"当成一个完整短语去找。
3.3 包含通配符:Shell 会先把 *.txt 展开
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep *.txt
dyl.txt:demo.txt 123 hello
test.txt:demo.txt 123 hello
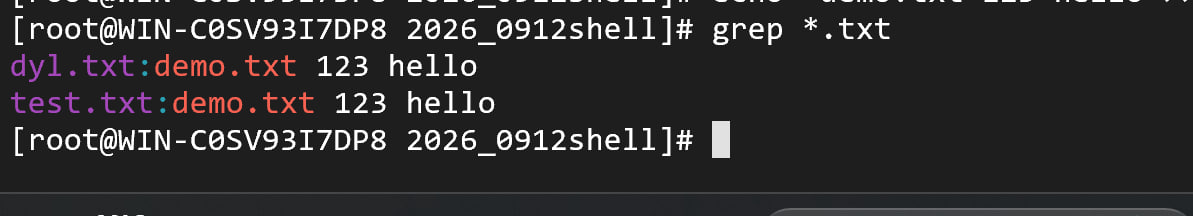
这一条最容易被误读,我一开始也纳闷:为什么输出前面带着 dyl.txt:、test.txt:?
原因在第一关:Shell 会先做文件名扩展(Globbing)。当时目录里有 demo.txt、dyl.txt、test.txt,Shell 把 *.txt 直接展开成了三个文件名,grep 实际拿到的是:
grep demo.txt dyl.txt test.txt
也就是说:第一个词被当成了"模式",后面的才是"文件"。所以它在 dyl.txt 和 test.txt 里搜"demo.txt“这个字符串,并把文件名前缀打印了出来。
再补一句更狠的:如果目录里只有一个 .txt 文件,这条命令就变成了 grep demo.txt——又没有文件参数,grep 转去读键盘输入,跟第 4.3 节那个坑一模一样。
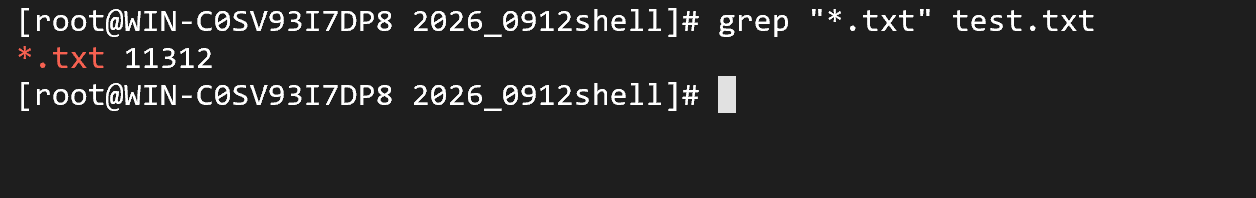
加上引号,通配符就不再展开,grep 会去找字面量 *.txt:
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep "*.txt" test.txt
*.txt 11312
3.4 包含变量 $:双引号会展开,单引号不会
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep "$HOME" /etc/passwd
root:x:0:0:Super User:/root:/bin/bash
operator:x:11:0:operator:/root:/usr/sbin/nologin
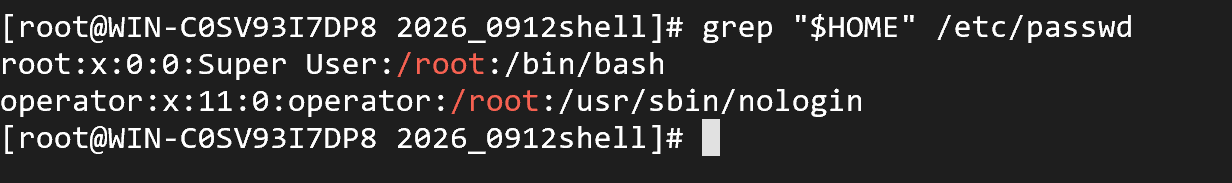
双引号不阻止变量替换:Shell 先把 $HOME 展开成 /root,grep 收到的模式其实是 /root,所以它匹配到的是含 /root 的行。
如果把双引号换成单引号:
grep '$HOME' /etc/passwd # 什么都没有,因为文件里没有 $HOME 这个字面量
单引号是强引用,Shell 不解析里面的任何东西,$HOME 原封不动交给 grep,于是 grep 去找字面量 $HOME。
这里和脚本里变量的引用规则完全一致:双引号"允许展开”,单引号"原样照抄"。
3.5 三种写法小结
| 写法 | Shell 会做什么 | 什么时候必须用它 |
|---|---|---|
| 不加引号 | 分词、展开变量、展开通配符、吃掉反斜杠 | 模式是纯字母、想偷懒时 |
| 双引号 | 保持整体、禁止通配符展开,但仍会展开 $ 和反引号 | 模式里有空格、有需要展开的变量 |
| 单引号 | 原样照抄,什么都不处理 | 写正则的默认选择(推荐) |
一句话结论:简单字符串加不加都一样;一旦有空格、通配符、$,就必须加,而且推荐用单引号。
4. 疑惑二:/example/ 在 grep 里为什么不好使
4.1 现象
学完 awk 之后,我以为 grep 也能用 // 包住模式,就试了一下——什么都搜不出来:
grep '/example/' demo.txt # 无输出

4.2 原因:/ 不是 grep 的定界符
// 是 awk、sed、Perl 那一类工具的定界符语法(awk '/example/' 才需要它),grep 没有这个语法。在 grep 眼里,斜杠 / 只是一个普通字符。
所以 grep '/example/' demo.txt 实际是在找"行里有没有连续的 /example/ 这个字符串(前后都带斜杠)"。我的 demo.txt 里只有 example,没有斜杠,自然搜不到。
顺便验证一下引号:
grep -E /example/ demo.txt       # 无输出
grep -E "/example/" demo.txt     # 无输出,结果完全一样
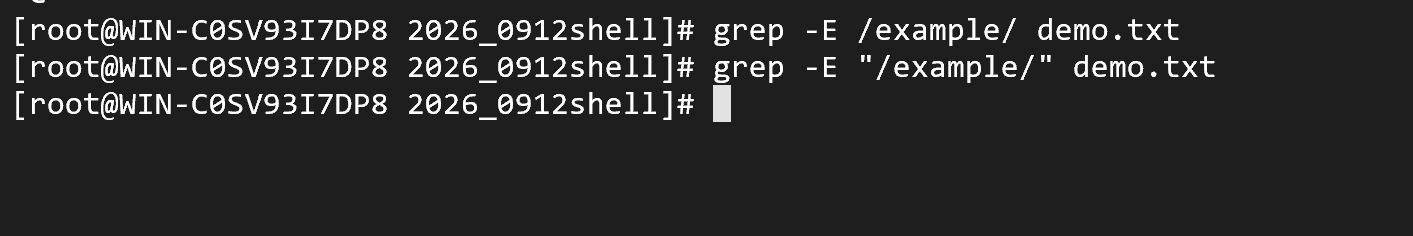
两条命令完全等价,原因还是 3.1 节那句:加不加双引号,Shell 剥完壳之后传给 grep 的都是 /example/——里面没有空格、没有变量、没有通配符,剥壳前后没差别。
想在 grep 里匹配 example,直接写模式就行:grep -E example demo.txt。
4.3 顺带踩的大坑:命令敲下去"没反应"
搜 /example/ 失败之后,我又想着"那用反斜杠包一下试试",于是敲了这么一条:
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep -E \example\ demo.txt
488
^C
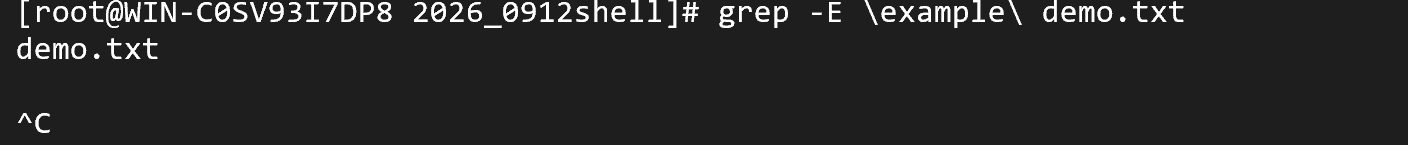
现象:回车之后没有任何输出,光标停在原地。我以为命令没生效,又敲了 demo.txt、敲了 488,结果它们被原样回显了出来,看起来就像卡住了。
(顺便解释一下那个让我困惑很久的 488:那是我自己敲进去、被终端回显的,不是 grep 的输出,更不是什么"第 488 行"。)
原因:\ (反斜杠 + 空格)把空格转义成了普通字符,空格不再是参数分隔符。于是 Shell 只切出两个参数:
-E
example demo.txt        ← 空格被转义,和 demo.txt 粘成了一个参数(这就是"模式")
结果就是:grep 拿到了模式 example demo.txt,但一个文件名都没有。这时候 grep 不会报错,它会按规矩转去读标准输入——也就是键盘。你在回车之后敲的每一个字符,都只是"喂给 grep 的数据",而不是命令参数。
分享里那句话说得最清楚,我直接抄下来:
命令行参数是在按回车之前由 Shell 解析的;按回车之后,grep 再让你输入的内容,只是标准输入,不是文件路径。
怎么退出:按 Ctrl + C 中断,或者按 Ctrl + D 结束输入(EOF)。
正确写法:让 demo.txt 作为一个独立的参数出现在命令行里,中间用没被转义的空格分开:
grep -E example demo.txt
作为对比,如果把末尾的反斜杠去掉、只留下 \+,命令立刻就有输出了:
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep -E \example\+ demo.txt
Hello, this is an example file.
example. example example
  example    exampleexampleexample
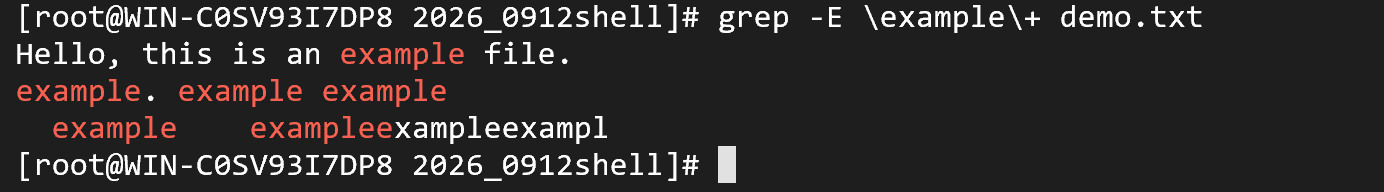
原因在第一关:不加引号时,Shell 会把 \e 里的反斜杠吃掉(变成 e),也会把 \+ 里的反斜杠吃掉(变成 +)。grep 真正收到的是 example+,而 -E 下 + 是量词(一个或多个),所以含 example 的行全被匹配出来了。
这也解释了为什么"同样是反斜杠",一条卡死、一条正常——关键不在反斜杠本身,而在它有没有把空格吃掉。
4.4 续行符:\ 放在什么位置才不翻车
命令太长想换行写,Bash 允许在行尾用 \ 续行。但它有两条铁律,我自己两条都踩过。
错误写法一:行尾 \ 前面没有空格
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep -E \example\
demo.txt
行尾的 \ 会把下一行直接接到当前行末尾,而且不会自动补空格。所以这两行拼成了:
grep -E \example\demo.txt → Shell 再去掉反斜杠 → grep -E exampledemo.txt
grep 收到一个模式 exampledemo.txt,还是没有文件名,于是又卡在键盘输入上。
正确写法:\ 前面留一个空格
[root@WIN-C0SV93I7DP8 2026_0912shell]# grep -E example \
demo.txt                        # 有些环境会显示续行提示符 >,有些不会
Hello, this is an example file.
example. example example
  example    exampleexampleexample
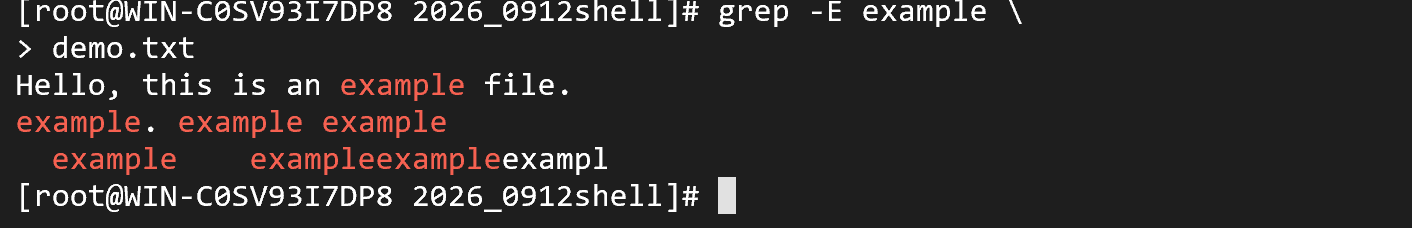
两条铁律总结:
\前面必须有一个空格(表示这里本来就是参数边界);\后面不能有空格,直接回车。
说实话,续行符这种东西能不用就不用,一行写完最省事。
5. 疑惑三:都是反斜杠,为什么有的匹配有的不匹配
5.1 三方对照表
我把当时试过的写法整理成一张表,这张表解决了我一半的疑惑。看表的时候注意顺序:先看 Shell 给了 grep 什么,再看 grep 怎么理解。
| 命令行写法 | Shell 解析后传给 grep 的模式 | grep 按哪套方言解释 | 实际匹配的字符串 |
|---|---|---|---|
grep '\example\+' demo.txt | \example\+ | BRE(默认) | example、examplee…(\e 被忽略,\+ 是量词) |
grep -E '\example\+' demo.txt | \example\+ | ERE | 字面量 example+(\+ 成了加号本身) |
grep \example\+ demo.txt(无引号) | example+ | BRE | 字面量 example+(BRE 里 + 是普通字符) |
grep -E \example\+ demo.txt(无引号) | example+ | ERE | example、examplee…(+ 是量词) |
grep -E 'example+' demo.txt | example+ | ERE | example、examplee… |
grep 'example' demo.txt | example | BRE | example |
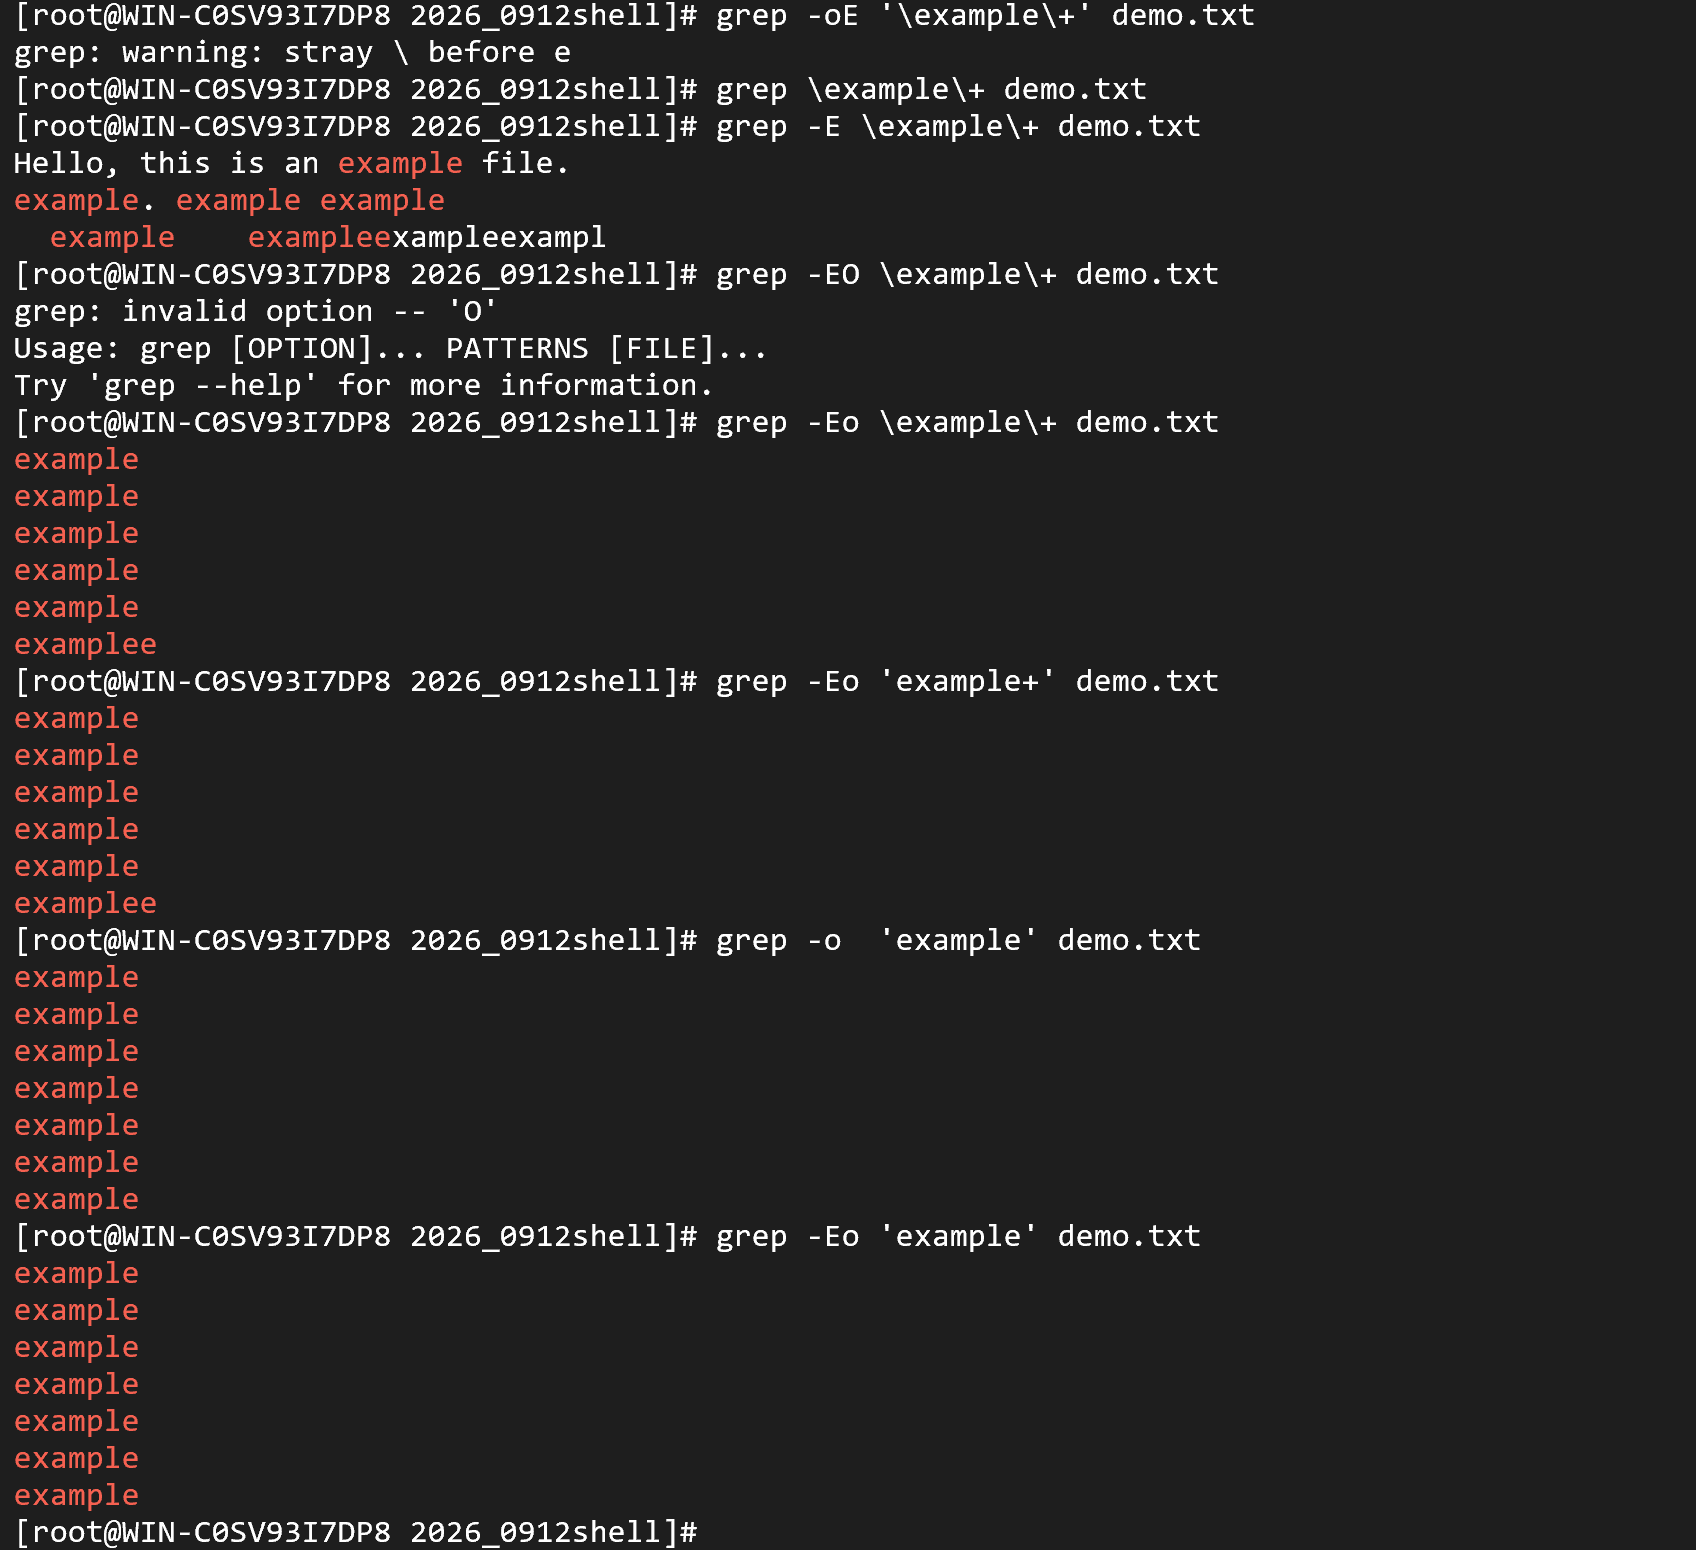
第三行和第四行是几乎相同的命令,只差一个 -E,结果就完全不同——因为同一串字符,第二关的方言不一样。
第一行和第二行也是几乎相同的命令,只差一对引号:单引号让反斜杠活着到了 grep,不加引号则被 Shell 吃掉了。
5.2 三条核心原则
- Shell 先解析:它决定"传给 grep 的字符串"到底是什么。
- grep 再解析:按 BRE(默认)或 ERE(
-E)的规则去理解这个字符串。 \e是无效转义:GNU grep 不认识\e,会打印一行警告grep: warning: stray \ before e,然后忽略这个反斜杠,当成普通字母e。所以'\example\+'会被它理解成example+,能匹配到example。
这个警告本身也值得记一下:它不报错、不中断,只是提醒你别乱加反斜杠。看到 stray \ before ...,基本就是模式里有多余的转义。
写正则的默认姿势:用单引号把整个模式包起来,里面不要乱加反斜杠。
grep -E 'example' demo.txt        # 想匹配 example,直接写,不要加 \e
grep -E 'example+' demo.txt       # 想匹配 example/examplee,+ 直接写
grep -E 'example\+' demo.txt      # 想匹配字面量 example+,才需要 \+
6. 疑惑四:+ 在 BRE 和 ERE 里完全是两回事
6.1 打开 ERE 的开关是 -E
grep 默认用的是 BRE(基本正则),加了 -E 才是 ERE(扩展正则)。这两套方言里,同一个符号的含义可能正好相反:
| 你想要的含义 | BRE(默认) | ERE(-E) |
|---|---|---|
| 一个或多个 | \+(GNU 扩展;POSIX 写法是 \{1,\}) | + |
| 零个或多个 | * | * |
| 零个或一个 | \? | ? |
| 或者 | | | ` |
| 分组 | \( \) | ( ) |
所以:想表达"一个或多个",要么写 grep -E 'example+',要么写 grep 'example\+',千万别混着写成 grep -E 'example\+'——最后这种写法里 \+ 是"字面加号",grep 会去找真正的 example+,当然找不到。
6.2 \d 为什么用不了:这是 -P 的事
我写模式的时候用过 \d、\w、\s,结果发现"用不了"。当时我以为是自己引号写错了,后来才搞明白,问题出在方言上。
先把名字说清楚:这个选项是 -P(大写),意思是"换用 PCRE(Perl Compatible Regular Expressions)引擎"。它不是什么"修饰符",也不叫"单行模式"——单行模式是 PCRE 里的 s 修饰符((?s)),和 -P 完全是两回事。顺便说一句,小写的 grep -p 这个选项根本不存在,敲了会直接报 invalid option。
再说现象。\d 在 -E 下不会报错,GNU grep 只是警告一句,然后把它退化成普通字母 d:
$ grep -E '\d' n.txt
grep: warning: stray \ before d
hello world          # 匹配到的其实是"含字母 d 的行"
这就是它比报错更坑的地方:命令看着执行成功了,其实意思已经悄悄变了。真正想匹配数字,得用 -P:
$ grep -P '\d+' n.txt
abc 123
num42
另外两个简写其实不需要 -P:
| 写法 | 能否直接用在 -E / BRE 里 | 说明 |
|---|---|---|
\d | 不能 | GNU grep 不认,-E 下会退化成字母 d,要配 -P |
\w | 能 | grep -oE '\w+' 正常输出单词(GNU 扩展) |
\s | 能 | 同上,也是 GNU 扩展 |
但要记住:\w、\s、\b 这些都是 GNU 自己扩展的,POSIX 标准以及 BSD/macOS 上的 grep 并不认。如果要写能在别的机器上跑的脚本,老老实实用 POSIX 字符类:[[:digit:]]、[[:space:]]、[[:alpha:]]。
再补一句:-P 本身也是 GNU 专有的——BSD / macOS 自带的 grep 根本没有 -P 这个选项,敲下去会直接报错。所以 \d 这条路在 macOS 上走不通,跨平台脚本里还是老老实实用 [[:digit:]]。
一句话记住:-E 只是换方言,-P 才是换引擎;\d 属于引擎级的东西。
7. 疑惑五:为什么两条不同的命令,结果一模一样
7.1 先看一个坑:字符集 [example]+
这个坑我一开始完全没意识到。当时我写的是:
grep -E [example]+ demo.txt
输出看起来很正常,example 被高亮了,我就以为"[example]+ 是匹配整个单词 example"。完全错了。
[example] 是字符集(等价于 [exampl],方括号里重复的字母没有意义),表示"匹配 e、x、a、m、p、l 中任意一个字母";后面的 + 让这个字符集连续重复。所以 [example]+ 的真正含义是:
匹配一段连续的、只由 e、x、a、m、p、l 这几个字母组成的串。
它之所以看起来"匹配了整个 example",纯粹是巧合——example 这个词的每个字母恰好都在集合里。换成别的词立刻露馅(下面都是 grep -oE '[example]+' 的真实输出):
| 输入文本 | [example]+ 实际匹配到 |
|---|---|
example | example(巧合,看起来像匹配了整个词) |
exams | exam(s 不在集合里,被截断) |
Hello | ell(藏在前面的单词里) |
banana | 三个独立的 a |
用最小实验一眼看穿:
$ echo "Hello" | grep -oE '[example]+'
ell
$ echo "exams" | grep -oE '[example]+'
exam
所以:字符集 [] 和分组 () 完全是两件事。想匹配"整个单词",要用下面这种写法。
7.2 分组 (example)+ 和字面量 example
把几个容易混的写法摆在一起,就清楚了:
| 写法 | 含义 | 能匹配 | 不能匹配 |
|---|---|---|---|
example | 字面量,找这个词 | example | examplee |
example+ | + 只管紧挨着它的那个 e | example、examplee、exampleee | exaample、exampleexample |
(example)+ | 整个单词重复一次或多次 | example、exampleexample | exaample |
[example]+ | 集合内任意字母连续重复 | ell、eaxmple | 几乎没有匹配不了的 |
这里最容易记错的是 example+:+ 只修饰紧挨着它的那一个字符(也就是末尾的 e),不是修饰整个单词。想匹配"一个或多个 e 后接 xample",得写 e+xample;想匹配"整个单词重复",才写 (example)+。
另外补一句:如果你只是要匹配、不打算在替换或提取里引用这个分组,可以写成 (?:example)+(非捕获组)——效果完全一样,只是不额外保存分组内容。
7.3 照妖镜 -o:把藏起来的差别照出来
我当时拿两条命令做对比,发现输出一模一样,就下结论说"这两个命令没差别":
grep -E "(example)+" demo.txt
grep "example" demo.txt
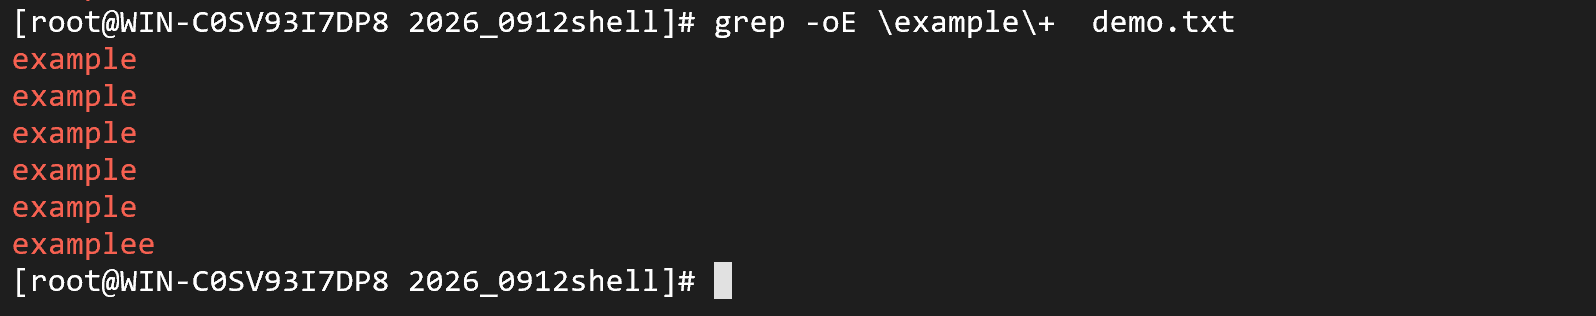
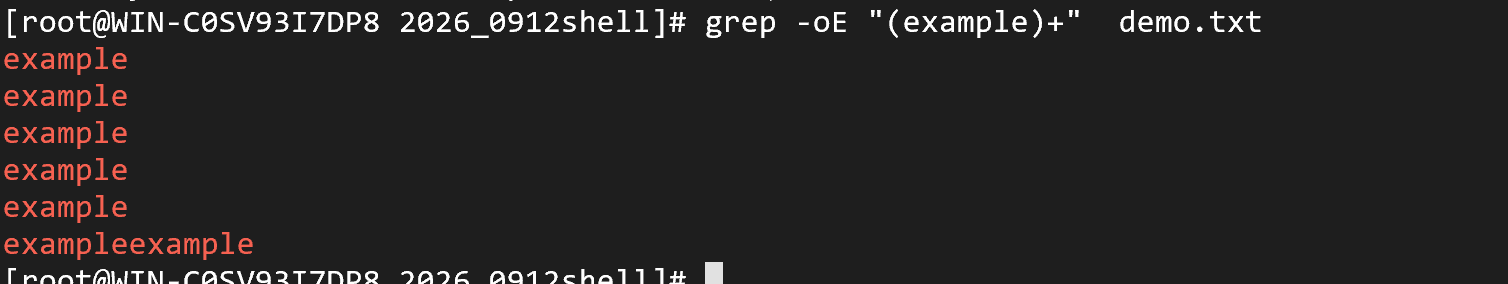
其实在这个文件、这两条命令下,我的观察是对的——输出确实一样。但"一样"的原因是:
grep 默认是"按行输出"的:只要这一行里包含匹配的内容,它就把整行打印出来。
而任何能匹配 (example)+ 的行(比如 exampleexample),必然也包含子串 example,所以两条命令打印出来的行完全相同。差别被"按行输出"这件事藏起来了。
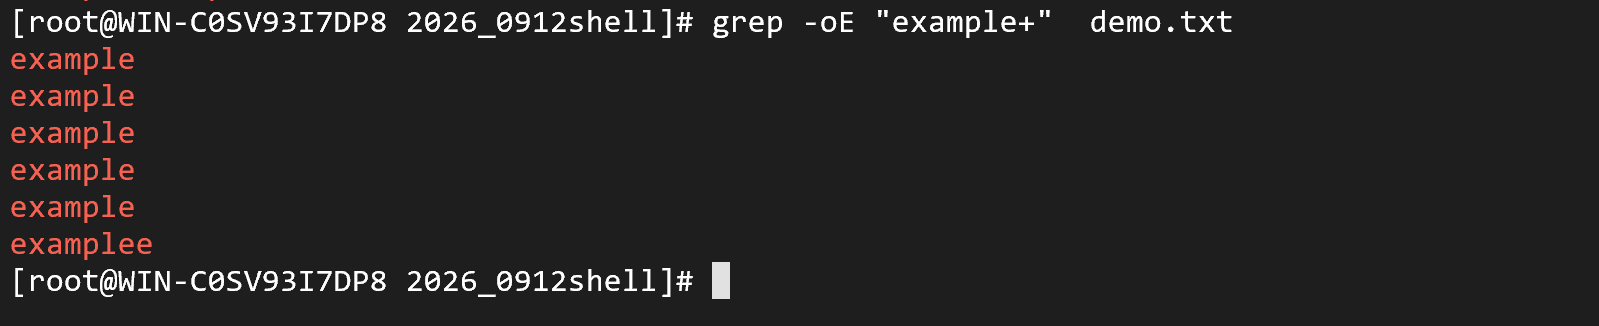
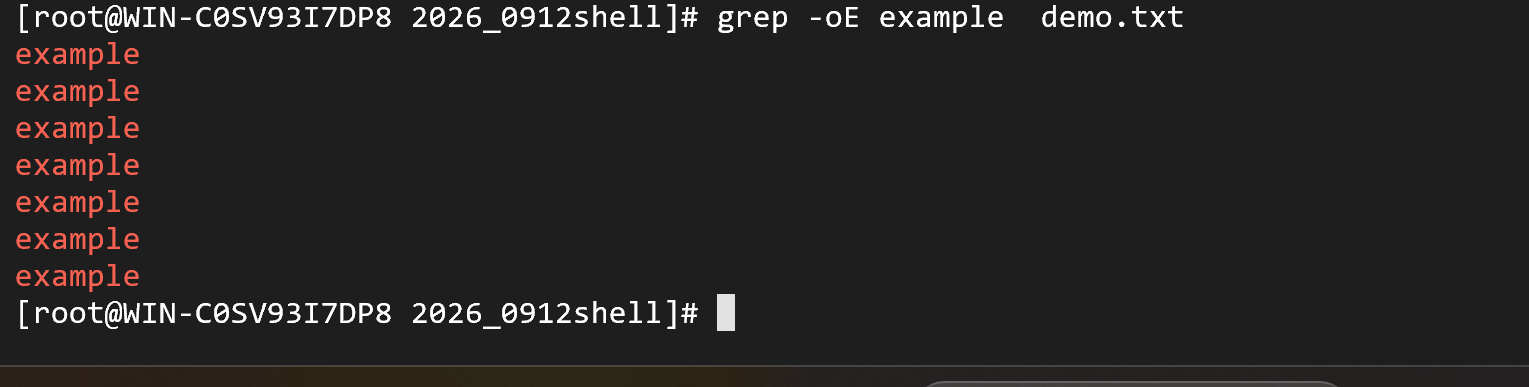
要看清底层差别,就得用 -o(only-matching,只输出匹配到的部分)。这是我看完分享后觉得最有用的一招:
$ echo "exampleexample" | grep -o "example"
example
example

$ echo "exampleexample" | grep -oE "(example)+"
exampleexample
同一个输入:example 认为那是两个单词,(example)+ 认为那是一个整体。
那什么时候才真的需要 (example)+?——提取(把连续的重复词抠出来)、替换(把 exampleexample 一次替换成一个 X,而不是三个 X)、严格限制格式(examplee 判错,exampleexample 判对)的时候。
平时只是"查有没有",grep example 就够了。
8. 疑惑六:grep -w 和 \b 是一回事吗
-w 的意思是强制匹配一个完整的"单词":匹配到的内容前后必须是"非单词字符"(空格、标点、行首、行尾都算)。
grep -w "example" demo.txt
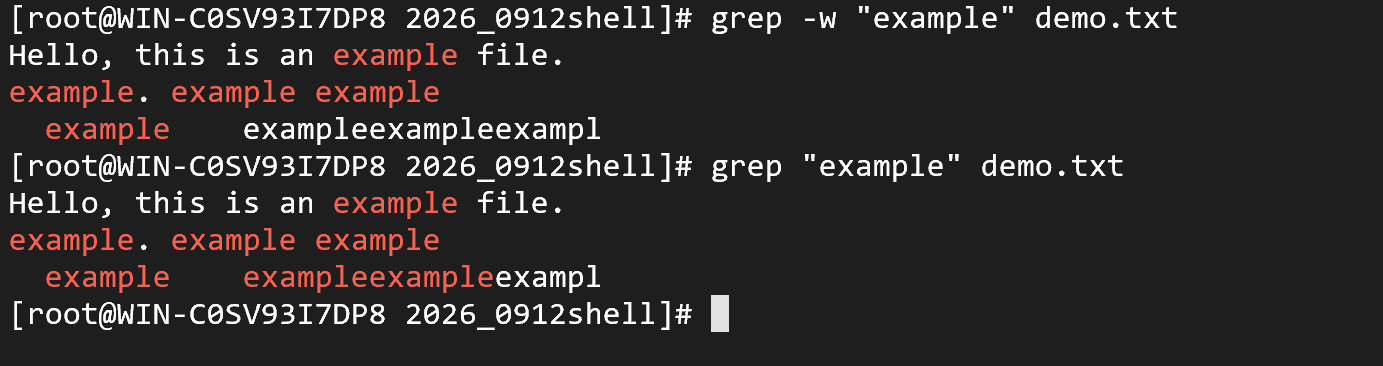
而 grep '\bexample\b' demo.txt 的效果是一样的:\b 是单词边界,前后各放一个,正好把 example 这个完整单词框住。
实测对比(同一个文件):
$ grep -o  'example' w.txt        # 4 个:myexample、example2 里的也算
$ grep -ow 'example' w.txt        # 2 个:排除了 myexample 和 example2
$ grep -o  '\bexample\b' w.txt   # 2 个:和 -w 结果一致
补充两点:
- 双引号写法
"\bexample\b"里的反斜杠之所以能活着到达 grep,是因为双引号的规则:Shell 在双引号里只对$、反引号、"、\、换行这几个字符特殊处理,其余反斜杠原样保留。不过既然全篇都推荐"写正则用单引号",这里也统一成'\bexample\b'更省心。 - 可移植性不同:
-w是 POSIX 标准选项,到处都有;\b是 GNU 扩展,BSD/macOS 的 grep 不认。写给别人用的脚本,优先-w。
9. 疑惑七:grep 和 awk 的边界在哪
一句话概括:grep 能做的 awk 基本都能做,awk 能做的 grep 不一定能做。
最直观的差别就在定界符上:awk 用 // 包住正则,grep 不用。
awk '/example/' demo.txt # 不写 action,默认打印整行
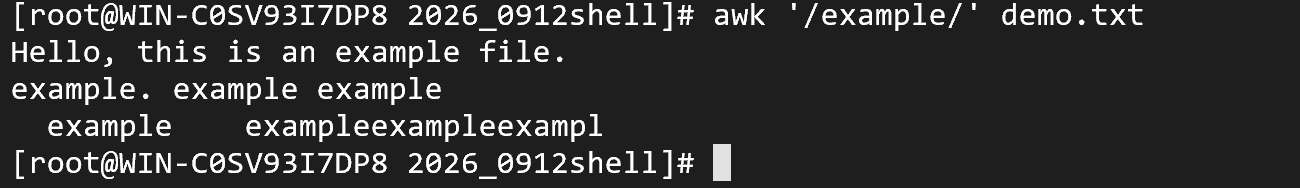
顺带记几个 awk 的写法,写脚本的时候很常用:
awk '/dyl/' file              # 等价于 awk '$0 ~ /dyl/':整行匹配正则
awk 'dyl' file                # 错:被当成变量,空值即假,什么都不输出
awk '$2 ~ /abc/ {print $1}' file   # 对:字段匹配正则(~ 是匹配运算符)
awk '$2 >= 80 {print $1}' file     # 对:数值比较(>= 是数学比较)
awk '$2 ~ >=80' file               # 错:正则和数值比较混用,直接语法错误
grep 这边就不用再举例了,查字符串本来就是它的专长。
10. 总结与速查表
回头看,这次复习最值钱的不是记住了几个选项,而是想通了那两件事:
- 一切先过 Shell。引号、空格、
$、*、反斜杠,第一关就会动手脚,grep 收到的常常不是你敲的那个东西。想看清真相,最简单的办法是echo一下,或者加引号。 - 第二关还有方言。BRE、ERE、PCRE 是三个不同的世界,
+、?、|、\d在里面的含义各不相同;而[ ]和( )更是完全不同的东西。
最后用一张速查表收尾(都在自己机器上验证过):
# ── 基础 ──
grep "example" demo.txt                 # 字面量(最常用)
grep -n "example" demo.txt              # 带行号
grep -c "example" demo.txt              # 统计匹配行数
grep -w "example" demo.txt              # 整词匹配,排除 myexample
grep -q "example" demo.txt && echo found   # 静默模式,用退出码判断

# ── 照妖镜:看匹配边界 ──
grep -o  "example" demo.txt             # 只输出匹配到的部分
grep -oE "example+" demo.txt            # 尾字母 e 重复
grep -oE "(example)+" demo.txt          # 整个单词重复
grep -oE '[example]+' demo.txt          # 字符集:会抠出 ell、le 这种碎片

# ── 正则方言 ──
grep    'example\+' demo.txt            # BRE:\+ 才是量词
grep -E 'example+' demo.txt             # ERE:+ 就是量词
grep -E 'example\+' demo.txt            # ERE:\+ 是字面加号(找 example+)
grep -P '\d+' demo.txt                  # PCRE:\d 才是数字
grep -F 'example+' demo.txt             # 固定字符串,不做正则解析

# ── 引号与反斜杠 ──
grep 'pattern' file                     # 写正则一律单引号,最安全
grep 'example' \
    demo.txt                            # 续行:\ 前要有空格、\ 后不能有空格

# ── 递归搜索 ──
grep -r "关键词" /root/                  # 递归,输出 文件:匹配行
grep -rnI --exclude-dir={.git,node_modules} "关键词" /root/
rg "关键词" /root/                       # ripgrep,大目录下快很多

# ── awk 对照 ──
awk '/dyl/' file                        # 正则定界符
awk 'dyl' file                          # 被当变量(空=假),什么都不输出
awk '$2 ~ /abc/ {print $1}' file        # 字段匹配正则
awk '$2 >= 80 {print $1}' file          # 数值比较
awk '$2 ~ >=80' file                    # 混用,语法错误

# ── 最小实验模板(最有用的一招)──
echo "测试文本" | grep -oE "你的正则"
遇到不确定的写法,别猜:echo 一个最小样本,再用 grep -o 把匹配到的部分打出来,一眼就能看出它到底理解成了什么。
评论
留言
无需注册,留个名字即可。理性发言,彼此尊重。
正在载入留言…